AI文書データ抽出とは?
AI文書データ抽出は、ユーザーが指定したフィールドを識別し、文書画像からその値を返します。ページ全体を再構築するのではなく、フィールド単位で出力するための機能です。
文書処理ワークフロー
継続的に発生する請求書、領収書、フォーム、ラベルなどの文書画像を、チームが必要とするビジネスフィールドに変換します。画像1枚から始めるほか、1つのフィールドリストでバッチを処理したり、APIで連携したりできます。
The Challenge
文書のレイアウトは、取引先、フォーム、情報源によって異なります。それでもワークフローには、確認して利用できる一貫したフィールドが必要です。
発行者は誰か。どの文書か。いつ作成され、合計はいくらか。
FreeOCR.AIの文書データ抽出ソフトウェアは、すべてのテキスト行を返すのではなく、指定された値に焦点を当てます。このインテリジェント文書処理により、画像ごとにフィールド単位の結果を返す文書データ抽出を自動化できます。
ビジネスフィールドの例
Workflow
固定座標のテンプレートを使わず、文書を繰り返し処理できるシンプルなワークフローです。
請求書、領収書、フォーム、ラベルなど、対応する文書画像を追加します。単発の作業には単一画像ツールを、複数ファイルにはログイン後のワークスペースを使用します。
処理に必要なフィールド名を入力します。バッチでは文書のレイアウトが異なっていても、すべての画像に同じフィールドリストが適用されます。
各結果を確認し、値をコピーするほか、表計算ファイルをダウンロードしたり、APIから構造化レスポンスを取得して次の処理に渡したりできます。
In Practice
一括処理ワークスペースでは、フィールド定義、複数画像の処理、ファイル別の履歴を、反復可能な1つの文書データ抽出ワークフローにまとめられます。
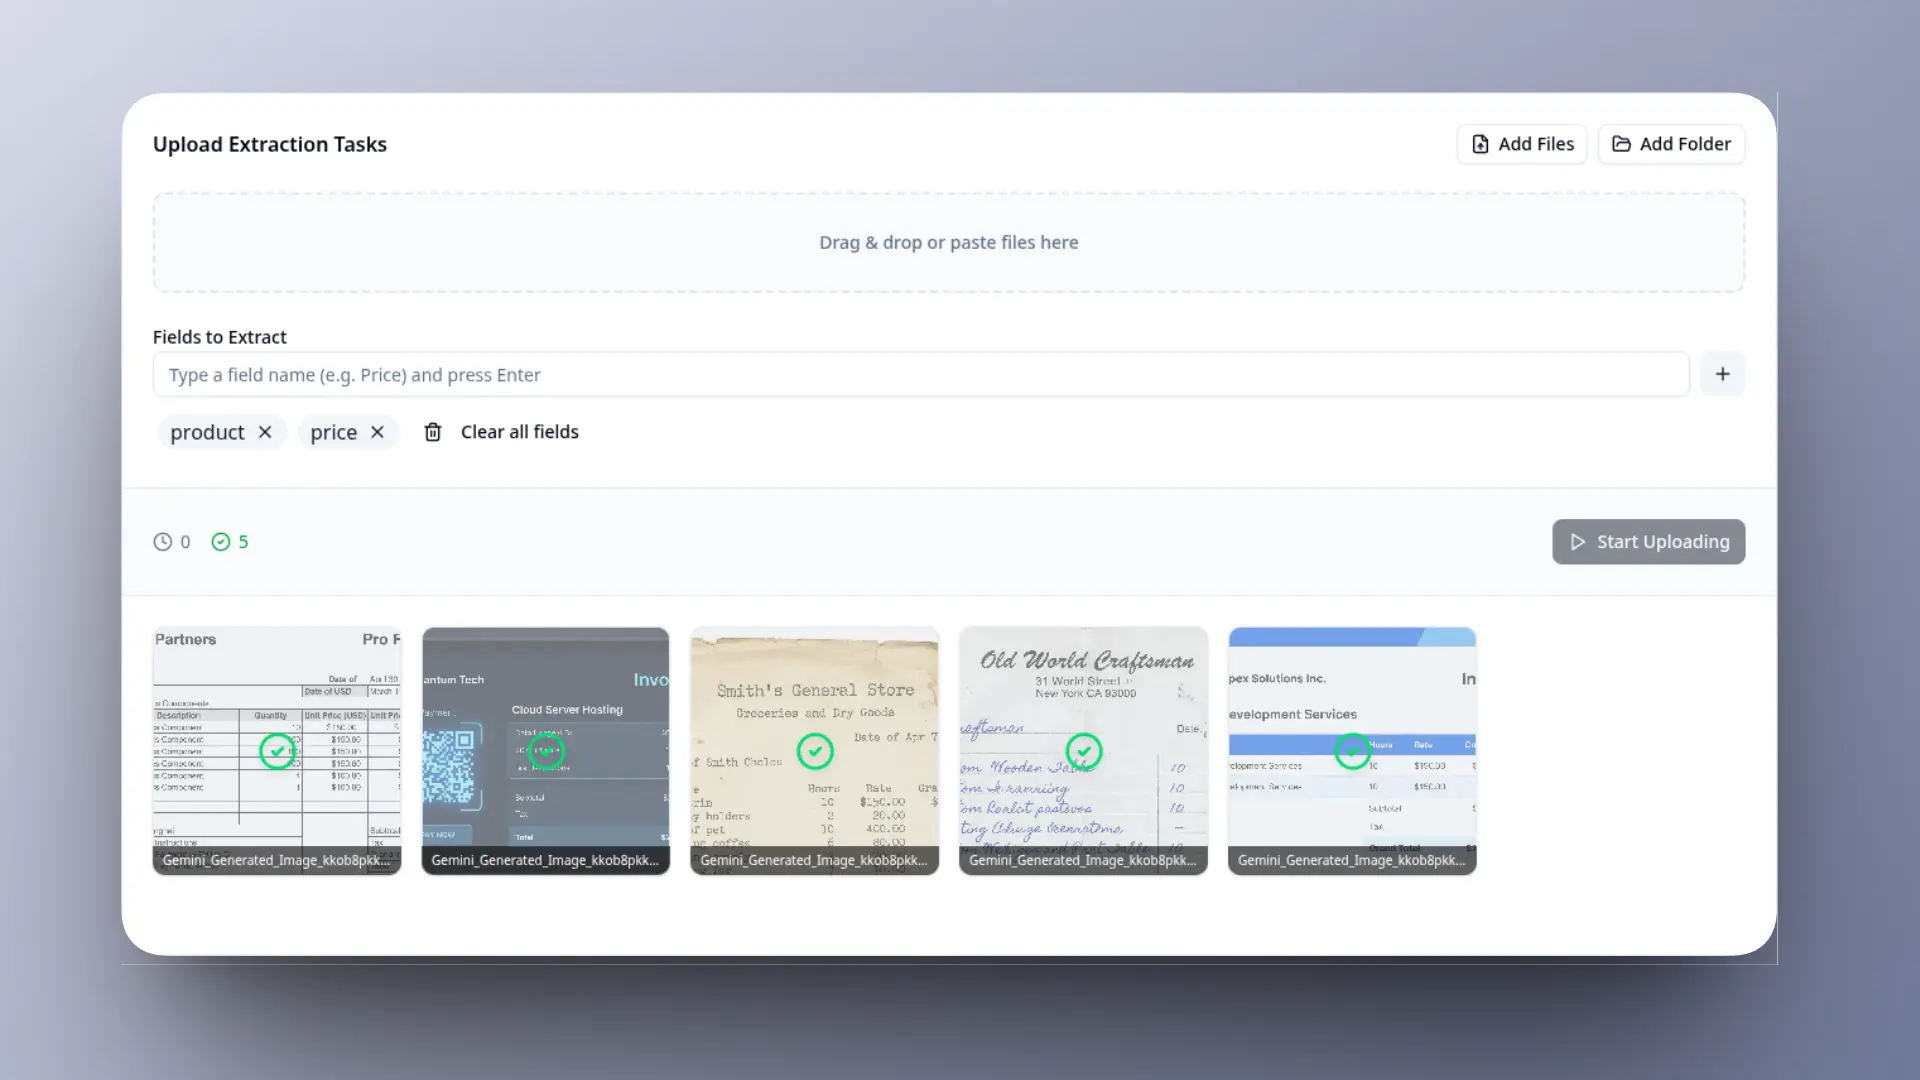
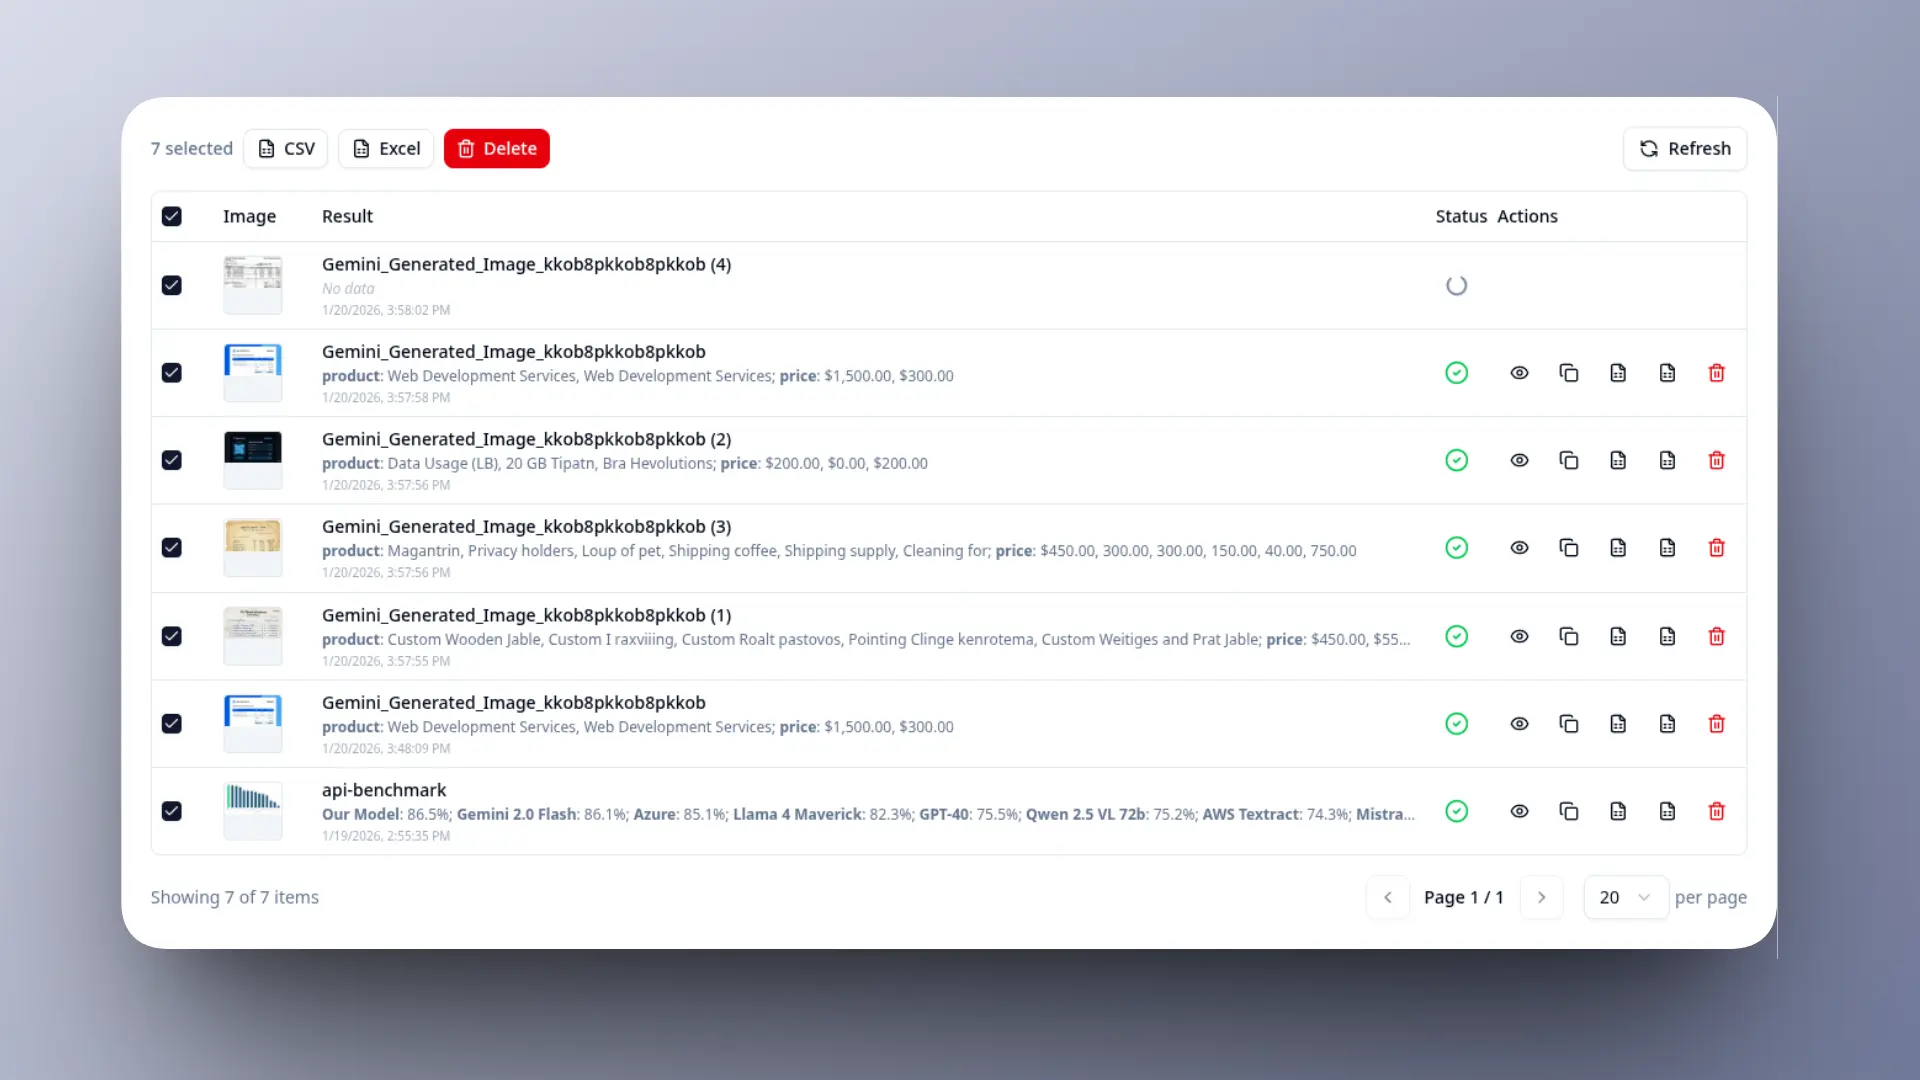
定期的に処理する文書セットでは、1つのフィールドリストを複数の画像に適用し、各結果を抽出履歴に保持できます。
Choose a Path
作業量と反復性に合った方法を選択します。
Use Cases
取引先、文書番号、日付、通貨、税額、小計、合計を指定して取得します。
氏名、日付、参照番号、住所、指定したフォーム値を取得します。
追跡番号、差出人と受取人の情報、住所、荷物の参照情報を取得します。
商品名、識別子、表示価格、表示されているカテゴリーフィールドを取得します。
表示されている氏名、文書番号、会社名、日付、連絡先情報を取得します。
確認や後のインポートに使用する、指定した指標、日付、識別子、値を取得します。
Choose a Tool
元の文書だけでなく、後続処理に必要なデータ構造に基づいて選択します。
Structured Output
インターフェース上でデータを確認するほか、表計算、アプリケーション、後のインポート処理に渡すことができます。
画面上でフィールドを確認し、1件またはすべての結果をコピーして、CSVまたはXLSXをダウンロードできます。
処理した画像ごとに個別の結果を保持し、選択したファイルを個別またはZIPでダウンロードできます。
デフォルトではJSONの結果オブジェクトを受け取ります。指定によりCSVまたはXLSX形式のレスポンスも利用できます。
現在、データ抽出で受け付けるのは文書画像であり、PDFファイルには対応していません。画像品質やレイアウトの変化が結果に影響する場合があるため、重要な財務情報、本人確認情報、業務上の値は後続処理で使用する前に確認してください。バッチ履歴では結果がファイル単位で保持され、すべての文書が1つの表計算ファイルに統合されることはありません。
FAQ
AI文書データ抽出は、ユーザーが指定したフィールドを識別し、文書画像からその値を返します。ページ全体を再構築するのではなく、フィールド単位で出力するための機能です。
表示テキストをすべて取得する場合はOCRが適しています。文書データ抽出は、取引先、日付、文書番号、追跡番号、合計など、指定した値の取得に適しています。
はい。独自のフィールド名を単純なリストとして入力できます。現在のワークフローでは、型付きまたは入れ子構造のJSON Schemaではなく、フラットなフィールド名を使用します。
はい。バッチワークスペースでは、バッチ内の各画像に1つのフィールドリストを適用し、ファイルごとに個別のステータスと結果を保存します。
はい。認証済みAPIは、フィールド名を指定した画像を受け取り、デフォルトでJSONを返します。CSVまたはXLSXのレスポンスも選択できます。APIリクエストには有料のAPIクレジットを使用します。
はい。画像の鮮明さや文書のレイアウトが抽出結果に影響するため、重要な値は、支払い、レポート作成、インポートなどの後続処理の前に確認してください。
文書画像1枚を試す、繰り返し発生するバッチを処理する、または文書のフィールド抽出をアプリケーションに接続できます。