Как преобразовать PDF в Markdown?
Скачайте FreeOCR Desktop, выберите один или несколько PDF, укажите Markdown как формат результата и запустите OCR. Для каждого исходного PDF будет сохранён отдельный файл .md.
PDF OCR
Выберите несколько PDF или целую папку. FreeOCR Desktop обработает сканированные, состоящие из изображений и многостраничные документы, распознает заголовки, списки, таблицы и формулы и сохранит отдельный редактируемый файл .md для каждого PDF.
PDF конвертируются в FreeOCR Desktop, а не в браузере, по 1 кредиту за страницу. Войдите в тот же аккаунт и используйте постоянные кредиты или кредиты подписки; подписка не обязательна.
PDF TYPES
FreeOCR визуализирует каждую страницу и читает её видимую структуру, поэтому работает с PDF как с текстовым слоем, так и без него.
MARKDOWN
Результат сохраняет полезную структуру документа в переносимом формате для редакторов, репозиториев и ИИ-процессов.
WORKFLOW
Обрабатывайте PDF целиком в настольном приложении вместо загрузки каждой страницы в браузере.
Выберите PDF-файлы или папку
Выберите Markdown как формат
Запустите OCR и сохраните файлы .md
PRODUCT PROOF
Реальный запуск FreeOCR Desktop — от выбора PDF до сохранения результатов Markdown.
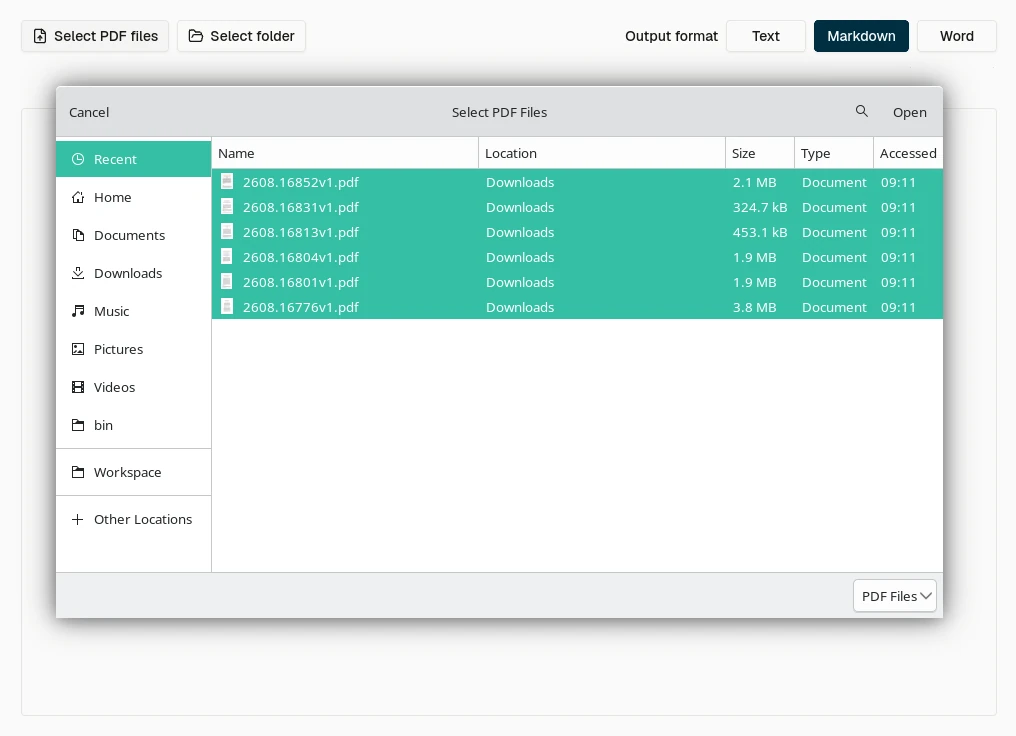
Выберите сразу несколько PDF или добавьте целую папку на экране PDF OCR.
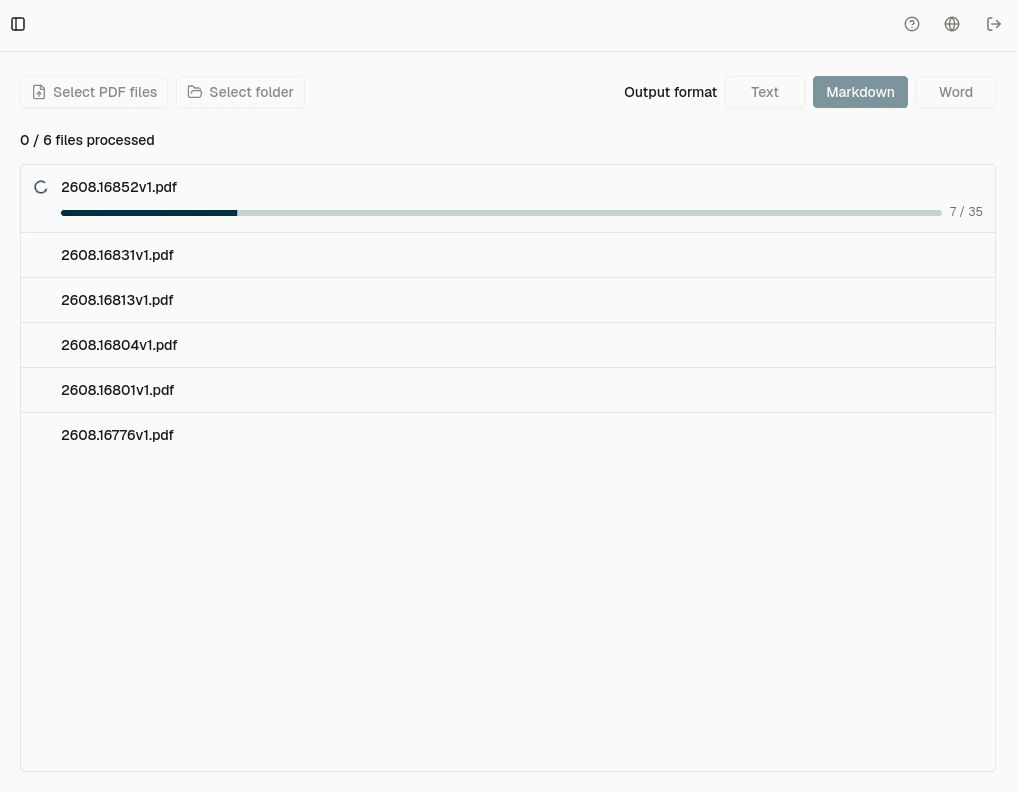
Один раз выберите Markdown для пакета и следите за обработкой страниц каждого PDF.
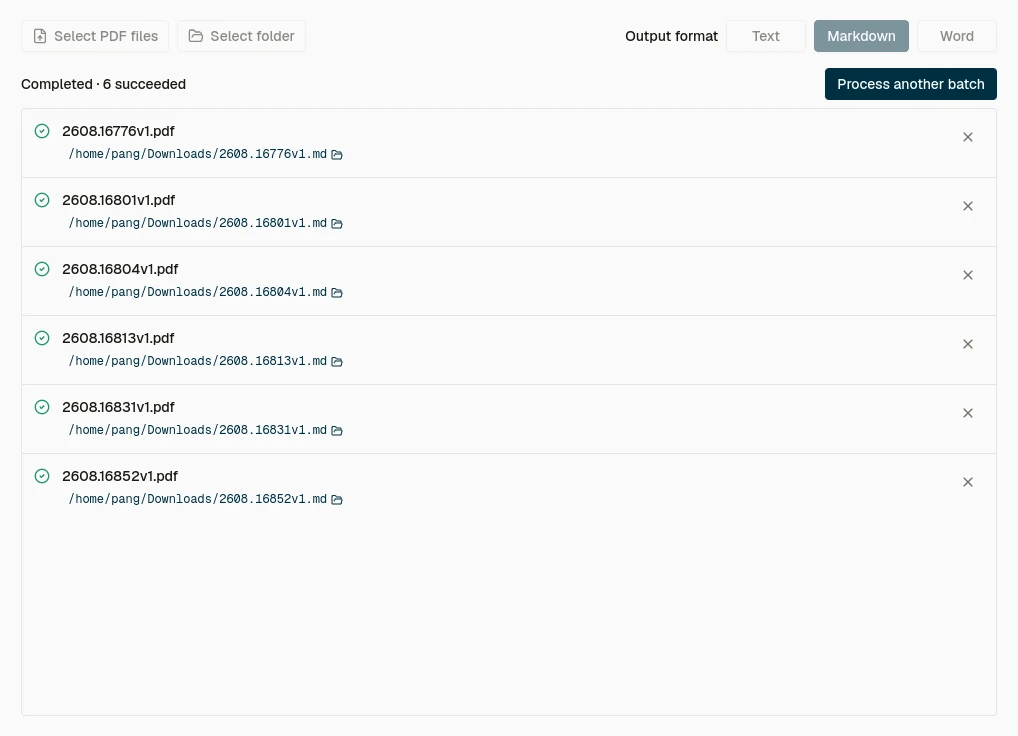
Каждый готовый PDF сохраняется в отдельный файл .md, а путь к нему отображается в очереди.
EXAMPLE
Одна и та же страница научной статьи до и после обработки в FreeOCR Desktop.
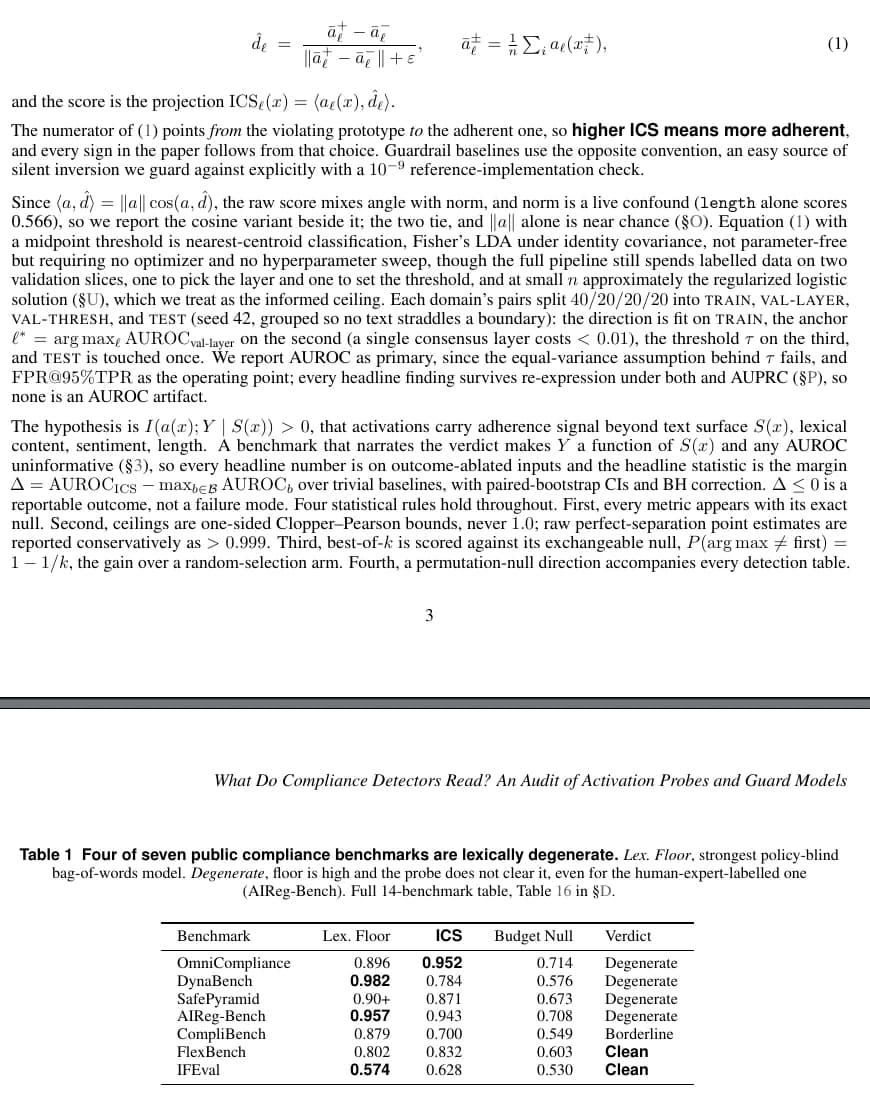
Исходная страница PDF с абзацами, математическими формулами и таблицей результатов.
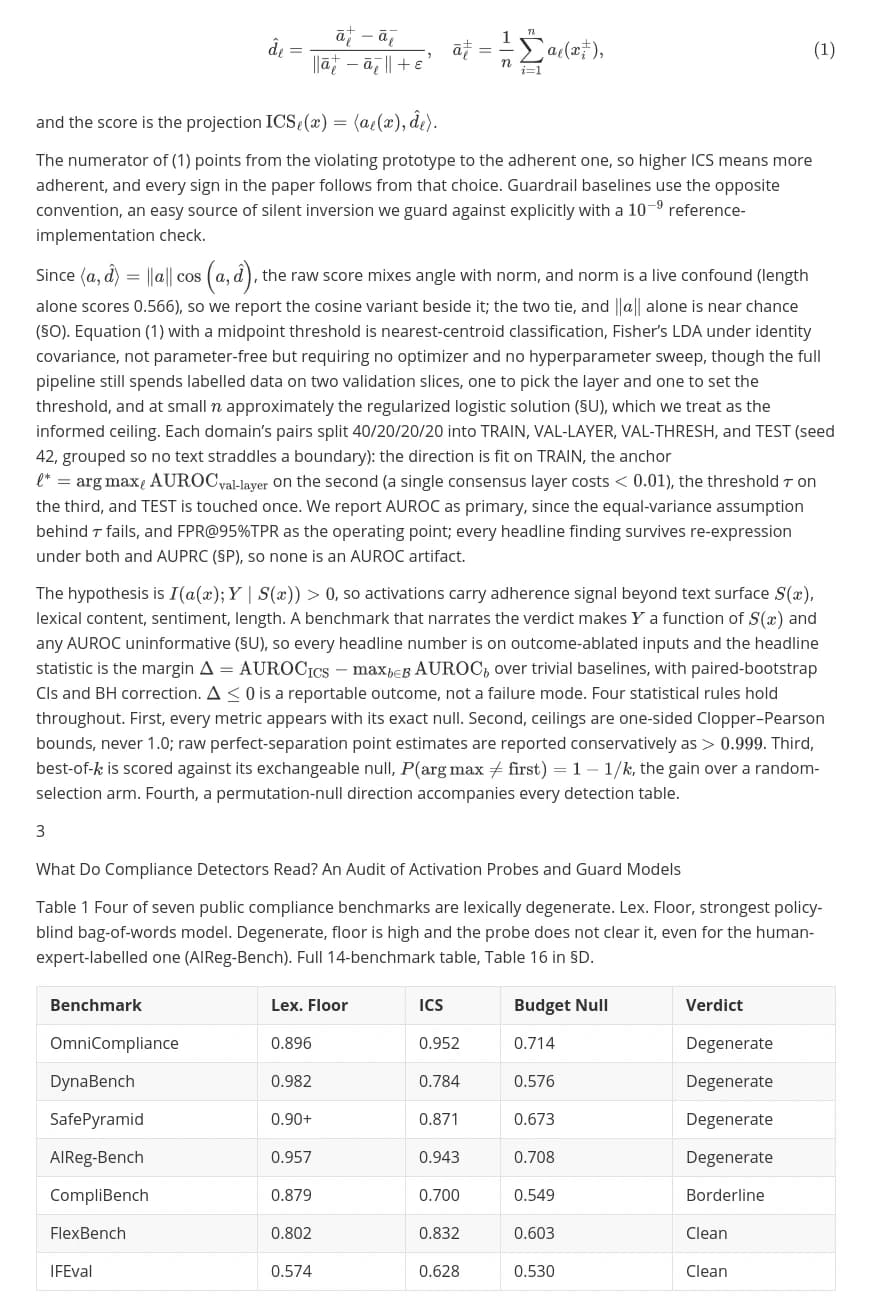
Результат Markdown для той же страницы PDF с сохраненными текстом, формулами и таблицей.
BATCH
Desktop обрабатывает документы целиком и повторяющиеся задачи без предварительного разделения PDF на снимки.
USES
Markdown удобен, когда документ нужно использовать за пределами фиксированной вёрстки страницы.
LIMITS
Преобразование PDF не является полностью без потерь. Проверьте Markdown перед публикацией или рабочим использованием.
RELATED
Используйте Markdown для переносимого структурированного текста или другой процесс FreeOCR, если нужен иной формат.
FAQ
Скачайте FreeOCR Desktop, выберите один или несколько PDF, укажите Markdown как формат результата и запустите OCR. Для каждого исходного PDF будет сохранён отдельный файл .md.
Да. FreeOCR визуализирует каждую страницу и использует ИИ OCR, поэтому читает сканированные PDF и PDF-изображения без выделяемого текста.
FreeOCR может представить распознанные таблицы синтаксисом Markdown, а формулы — совместимым с Markdown LaTeX. Результат зависит от качества скана и требует проверки.
Да. В Desktop можно выбрать несколько PDF или папку. Документы будут поставлены в очередь, и для каждого PDF сохранится отдельный файл Markdown.
Нет. Преобразование PDF целиком выполняется в FreeOCR Desktop, а не в браузере. Настольный процесс поддерживает многостраничные PDF и несколько файлов.
PDF конвертируются в FreeOCR Desktop, а не в браузере, по 1 кредиту за страницу. Войдите в тот же аккаунт и используйте постоянные кредиты или кредиты подписки; подписка не обязательна. Desktop показывает число страниц и проверяет доступные кредиты до начала обработки.
Скачайте FreeOCR Desktop, выберите PDF и экспортируйте структурированные файлы .md с помощью ИИ OCR.
1 кредит за страницу PDF · Поддерживаются несколько PDF и папки