Процесс обработки документов

Извлечение данных из документов с помощью ИИ для бизнес-процессов

Преобразуйте регулярно поступающие счета, чеки, формы, этикетки и другие изображения документов в бизнес-поля, необходимые вашей команде. Начните с одного изображения, обработайте пакет с единым списком полей или подключитесь через API.

The Challenge

Разные документы. Одни и те же бизнес-вопросы.

Макеты документов отличаются в зависимости от поставщика, формы или источника. При этом вашему процессу по-прежнему нужны единообразные поля, которые можно проверить и использовать.

Кто его выпустил? Что это за документ? Когда он был создан и какова итоговая сумма?

Программа FreeOCR.AI для извлечения данных из документов ориентирована на запрошенные значения, а не на возврат каждой строки текста. Такой подход к интеллектуальной обработке документов поддерживает автоматизированное извлечение данных из документов и возвращает результаты по каждому полю для каждого изображения.

Примеры бизнес-полей

ПоставщикНомер документаДатаВалютаНалогИтого

Workflow

Автоматизированный процесс извлечения данных из документов

Простой процесс для регулярной обработки документов без шаблонов с фиксированными координатами.

01

Соберите изображения документов

Добавьте счет, чек, форму, этикетку или другое поддерживаемое изображение документа. Для разовой задачи используйте инструмент для одного изображения, а для нескольких файлов — рабочую область авторизованного пользователя.

02

Задайте поля один раз

Введите названия полей, необходимых вашему процессу. В пакете один и тот же список полей применяется к каждому изображению, даже если макеты документов различаются.

03

Проверьте и передайте данные дальше

Проверяйте каждый результат, копируйте значения, скачивайте файлы электронных таблиц или запрашивайте структурированный ответ через API для следующего этапа обработки.

In Practice

Один список полей для всего пакета документов

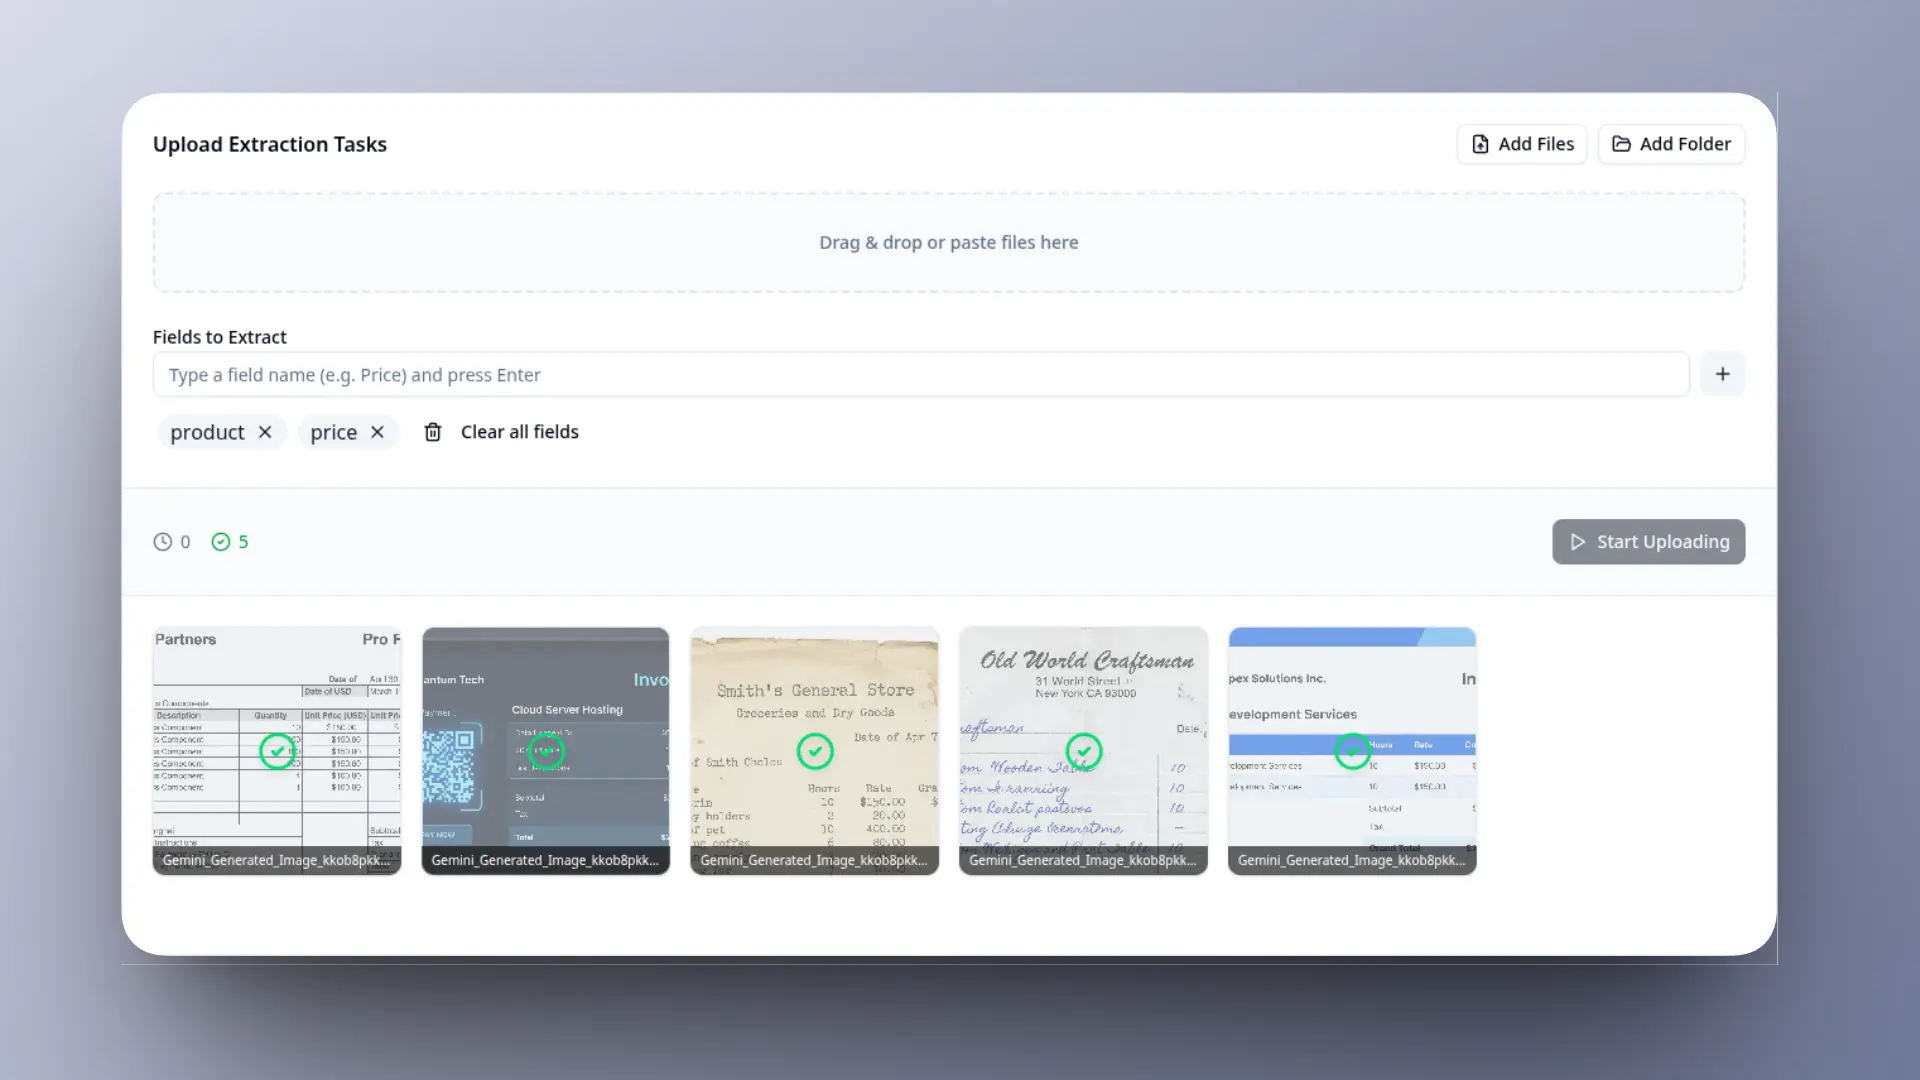
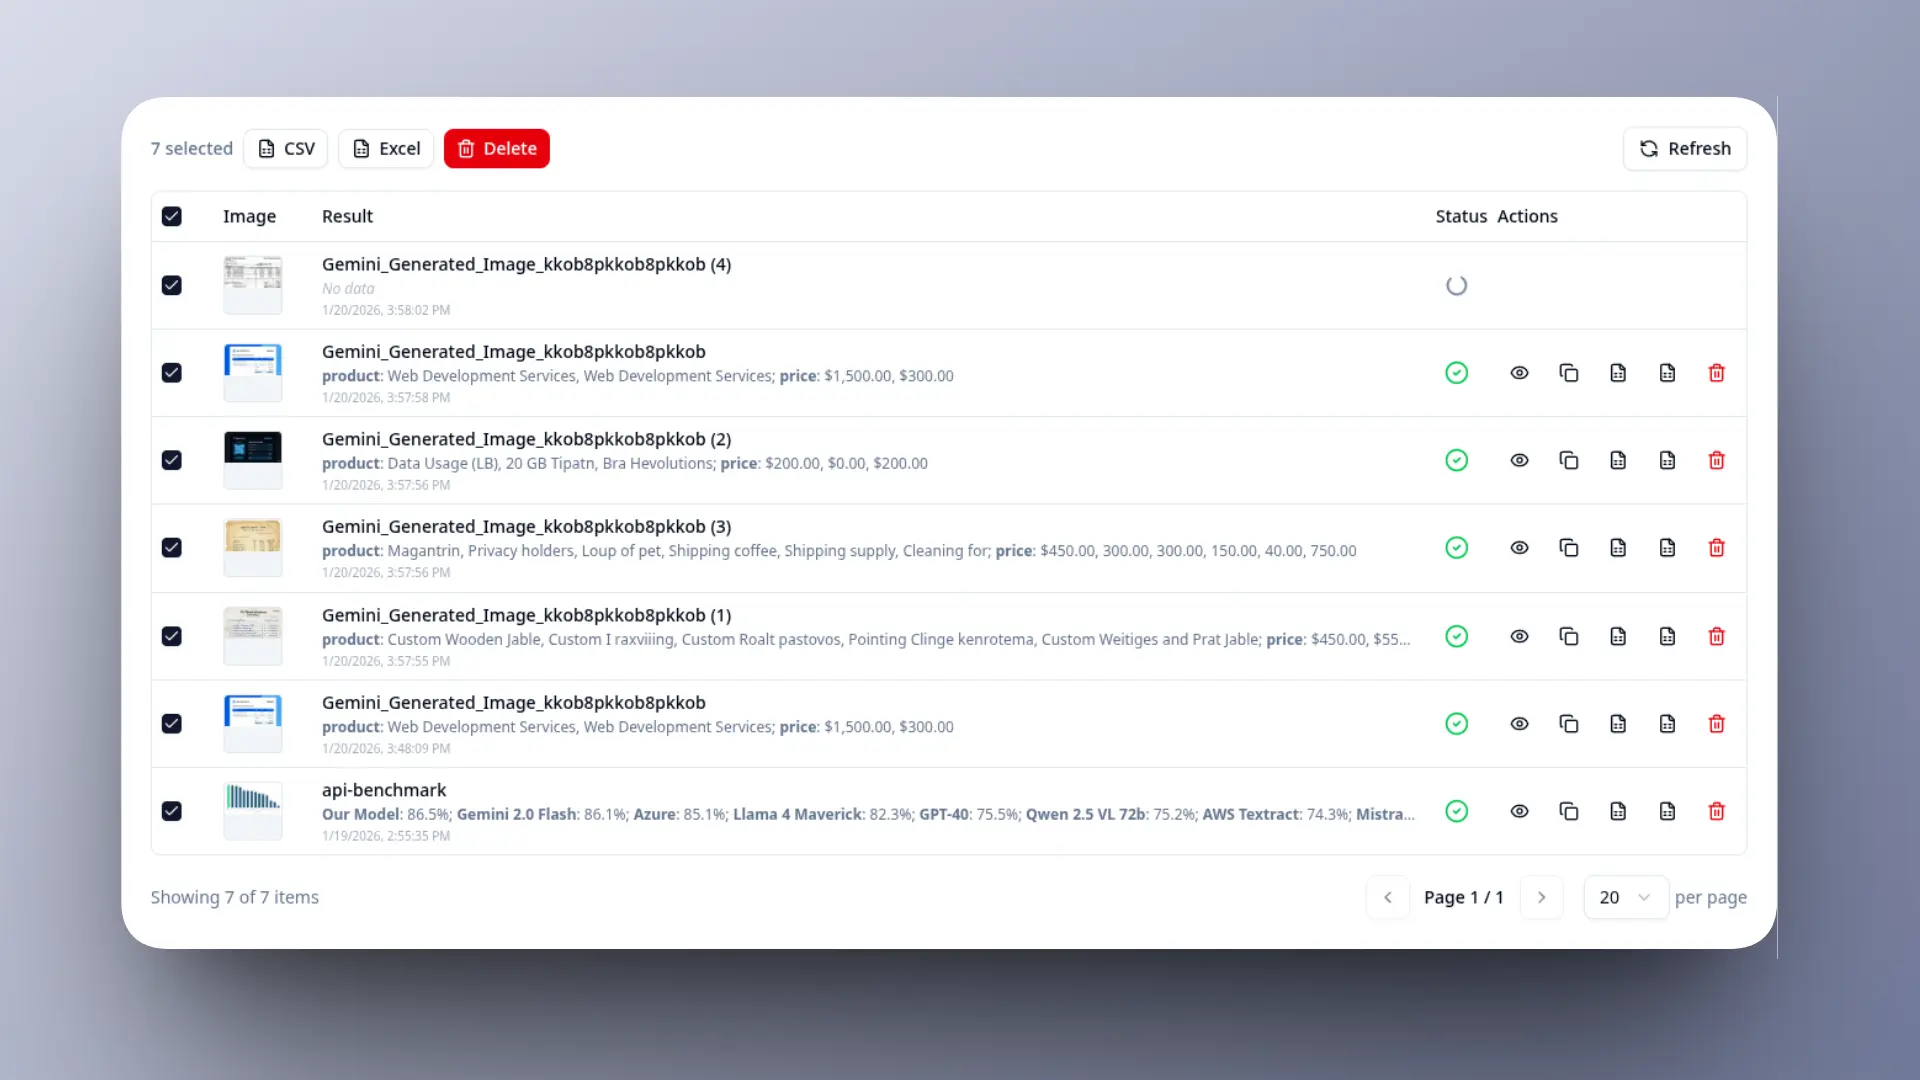
Пакетная рабочая область объединяет определение полей, обработку нескольких изображений и историю по каждому файлу в единый повторяемый процесс извлечения данных из документов.

Рабочая область для пакетной загрузки изображений документов с общим списком полей
Добавьте несколько изображений документов и задайте поля, которые нужно извлечь из каждого файла.
История извлечения данных из документов с результатами и действиями экспорта по каждому файлу
Проверьте статус и извлеченные значения по каждому файлу, затем скопируйте или скачайте нужные результаты.
ПАКЕТНАЯ РАБОЧАЯ ОБЛАСТЬ

Перенесите регулярную работу с документами в пакетный процесс

Для регулярно поступающих комплектов документов применяйте один список полей к нескольким изображениям и сохраняйте каждый результат в истории извлечений.

  • Один список полей для пакетаЗадайте необходимые поля до начала обработки файлов.
  • Статус и история по каждому файлуПросматривайте завершенные, выполняющиеся и неудачные задания и повторно запускайте неудачные.
  • Копирование и экспорт в CSV и ExcelСкачивайте результаты по каждому файлу; большие выборки можно упаковать в ZIP.
Choose a Path

Выберите подходящий процесс извлечения данных из документов

Выберите вариант, соответствующий объему и регулярности работы.

Use Cases

Бизнес-документы, которые можно преобразовать в данные по полям

Счета и чеки

Запрашивайте поставщика, номер документа, дату, валюту, налог, промежуточный итог и итоговую сумму.

Формы и заявки

Запрашивайте имена, даты, справочные номера, адреса и выбранные значения полей форм.

Транспортные и логистические документы

Запрашивайте номера отслеживания, сведения об отправителе и получателе, адреса и идентификаторы посылок.

Данные о товарах и ценах

Запрашивайте названия товаров, идентификаторы, указанные цены и видимые поля категорий.

Идентификационные и контактные данные

Запрашивайте видимые имена, номера документов, названия компаний, даты и контактные данные.

Исследовательские и операционные отчеты

Запрашивайте заданные показатели, даты, идентификаторы и значения для проверки или последующего импорта.

Choose a Tool

OCR, извлечение таблиц или извлечение данных из документов?

Выбирайте с учетом структуры, необходимой дальнейшему процессу, а не только исходного документа.

Structured Output

Структурированные результаты для следующего этапа

Проверяйте данные в интерфейсе или передавайте их в электронную таблицу, приложение либо процесс последующего импорта.

Результаты для одного изображения

Просматривайте поля на экране, копируйте один или все результаты и скачивайте CSV или XLSX.

Пакетная история по каждому файлу

Храните отдельный результат для каждого обработанного изображения и скачивайте выбранные файлы по отдельности или в ZIP.

Ответы API

По умолчанию получайте объект результата JSON; по запросу доступны варианты ответа в CSV и XLSX.

Предусмотрите проверку в важных процессах

В настоящее время извлечение данных принимает изображения документов, а не файлы PDF. Качество изображения и изменения макета могут влиять на результаты, поэтому проверяйте важные финансовые, идентификационные и операционные значения перед дальнейшим использованием. В пакетной истории результаты хранятся отдельно по каждому файлу, а не объединяются из всех документов в одну электронную таблицу.

FAQ

Частые вопросы об извлечении данных из документов с помощью ИИ

Что такое извлечение данных из документов с помощью ИИ?

Извлечение данных из документов с помощью ИИ находит запрошенные пользователем поля и возвращает их значения из изображений документов. Оно предназначено для вывода данных по полям, а не для полного воссоздания страницы.

Чем извлечение данных из документов отличается от OCR?

OCR подходит для получения всего видимого текста. Извлечение данных из документов подходит для отдельных значений, таких как Поставщик, Дата, Номер документа, Номер отслеживания или Итого.

Можно ли задать поля, необходимые моему процессу?

Да. Введите собственные названия полей простым списком. Текущий процесс использует плоские названия полей, а не типизированную или вложенную JSON Schema.

Можно ли применить одни и те же поля к нескольким документам?

Да. Пакетная рабочая область применяет один список полей к каждому изображению в пакете и сохраняет отдельные статус и результат для каждого файла.

Есть ли API для извлечения данных из документов?

Да. API с аутентификацией принимает изображение с названиями полей и по умолчанию возвращает JSON; также доступны ответы в CSV или XLSX. Запросы к API используют платные API-кредиты.

Нужно ли проверять извлеченные из документов данные?

Да. Четкость изображения и макет документа влияют на извлечение, поэтому важные значения следует проверять перед оплатой, подготовкой отчетности, импортом или другим последующим действием.

Выберите, как продолжить работу с документами

Протестируйте одно изображение документа, обработайте регулярный пакет или подключите извлечение полей из документов к своему приложению.

ИИ-система извлечения данных из документов | FreeOCR.AI