Интеллектуальный OCR для рабочего стола
Повысьте свою продуктивность с помощью нашего нативного приложения для рабочего стола. Разработано для больших нагрузок и профессиональной обработки документов.
Desktop находится в активной разработке. С предложениями или проблемами пишите на admin@freeocr.ai
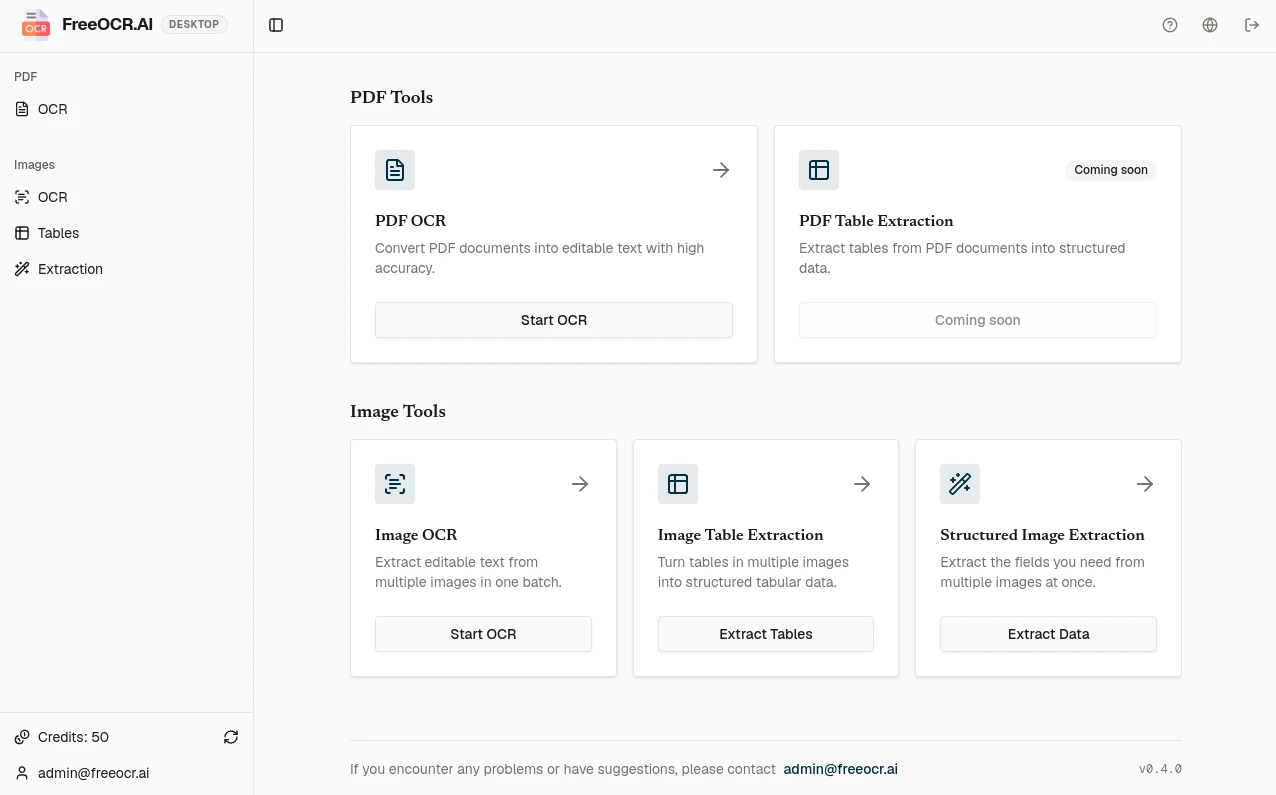
Создано для профессионалов
Пакетное преобразование PDF-документов в редактируемые форматы с высокой точностью и сохранением макета.
Улучшенные модели ИИ, специально настроенные для распознавания рукописных заметок и документов.
Легкое извлечение сложных математических формул и уравнений в формат LaTeX или редактируемый текст.
Интеллектуальное распознавание таблиц с сохранением структуры даже для вложенных или безграничных таблиц.
PDF OCR
Пакетная обработка PDF в трёх форматах
Выберите один раз
Несколько PDF или целую папку
Каждый документ обрабатывается отдельно и получает свой результат.
PDF в текст
TXT намеренно удаляет визуальное форматирование и создаёт лёгкий текст, который просто открыть, скопировать, найти и использовать повторно.
Подробнее о PDF в текстPDF в Markdown
Сохраните полезную структуру документа в переносимом формате для редакторов, репозиториев и ИИ-процессов.
Подробнее о PDF в MarkdownPDF в Word
Преобразуйте отсканированные страницы в нативные редактируемые элементы Word, а не в простой текст или статичные изображения.
Подробнее о PDF в WordIMAGE BATCH
Обрабатывайте изображения пакетно и сохраняйте результаты рядом с оригиналами
Выберите один раз
Несколько изображений или целую папку
Извлекайте текст, таблицы или структурированные поля одним пакетом.
Изображение в текст
Пакетно экспортируйте редактируемые файлы текста, Markdown или Word.
Использовать OCR изображений онлайнИзображение в Excel
Пакетно преобразуйте таблицы на изображениях в файлы CSV или Excel.
Извлечь таблицы из изображений онлайнИзвлечение полей
Выберите поля, например номер счёта, дату или итоговую сумму, и пакетно экспортируйте структурированные данные.
Извлечь поля из изображений онлайнПоддерживаются JPG, JPEG, PNG, WebP, BMP, HEIC и HEIF. Изображения локально сжимаются перед загрузкой для обработки и не добавляются в облачную историю. Результаты сохраняются рядом с исходным изображением в виде файлов TXT, Markdown, Word, CSV или Excel без его перезаписи.
Ваша конфиденциальность — наш приоритет
Шифрование при передаче
Для OCR требуется подключение к интернету. Изображения или отрисованные страницы PDF передаются в облако по HTTPS для распознавания.
Результаты сохраняются локально
Результаты сохраняются на вашем компьютере и не добавляются в облачную историю.
RELEASE NOTES
Последние обновления
v0.4
Пакетная обработка изображений
- Преобразуйте группу изображений в текст, Markdown или Word.
- Извлекайте таблицы из изображений в файлы CSV или Excel.
- Выбирайте поля, например номер счёта, дату или итоговую сумму, и экспортируйте структурированные данные в CSV или Excel.
v0.3
Пакетная обработка PDF
- Обрабатывайте несколько PDF или целую папку в одной очереди.
- Экспортируйте каждый PDF в текст, Markdown или Word.
- Отслеживайте каждый файл, повторяйте неудачные PDF и сохраняйте результаты рядом с исходными файлами.
Готовы выйти на новый уровень?
Постоянные кредиты и кредиты подписки работают на обычных страницах, в рабочей области и в FreeOCR Desktop. Оба типа подходят для пакетной обработки; подписка не обязательна.