Workflow de traitement documentaire

Extraction de données documentaires par IA pour les workflows métier

Transformez les factures, reçus, formulaires, étiquettes et autres images de documents récurrents en champs métier dont votre équipe a besoin. Commencez par une image, traitez un lot avec une liste de champs unique ou connectez-vous via l’API.

The Challenge

Des documents différents. Les mêmes questions métier.

La mise en page des documents varie selon le fournisseur, le formulaire ou la source. Votre workflow a néanmoins besoin de champs cohérents qu’il peut vérifier et utiliser.

Qui l’a émis ? De quel document s’agit-il ? Quand a-t-il été créé et quel est le total ?

Le logiciel d’extraction de données documentaires de FreeOCR.AI se concentre sur les valeurs demandées au lieu de renvoyer chaque ligne de texte. Cette approche de traitement intelligent des documents permet d’automatiser l’extraction de données documentaires en renvoyant des résultats par champ pour chaque image.

Exemples de champs métier

FournisseurNuméro de documentDateDeviseTaxeTotal

Workflow

Un workflow automatisé d’extraction de données documentaires

Un workflow simple pour le traitement récurrent de documents, sans modèles à coordonnées fixes.

01

Rassembler les images de documents

Ajoutez une facture, un reçu, un formulaire, une étiquette ou une autre image de document prise en charge. Utilisez l’outil pour image unique pour une tâche ponctuelle ou l’espace de travail réservé aux utilisateurs connectés pour plusieurs fichiers.

02

Définir les champs une seule fois

Saisissez les noms des champs nécessaires à votre processus. Dans un lot, la même liste de champs est appliquée à chaque image, même si la mise en page des documents diffère.

03

Vérifier et poursuivre le traitement des données

Vérifiez chaque résultat, copiez les valeurs, téléchargez des fichiers de feuille de calcul ou demandez une réponse structurée via l’API pour l’étape de traitement suivante.

In Practice

Une liste de champs pour tout un lot de documents

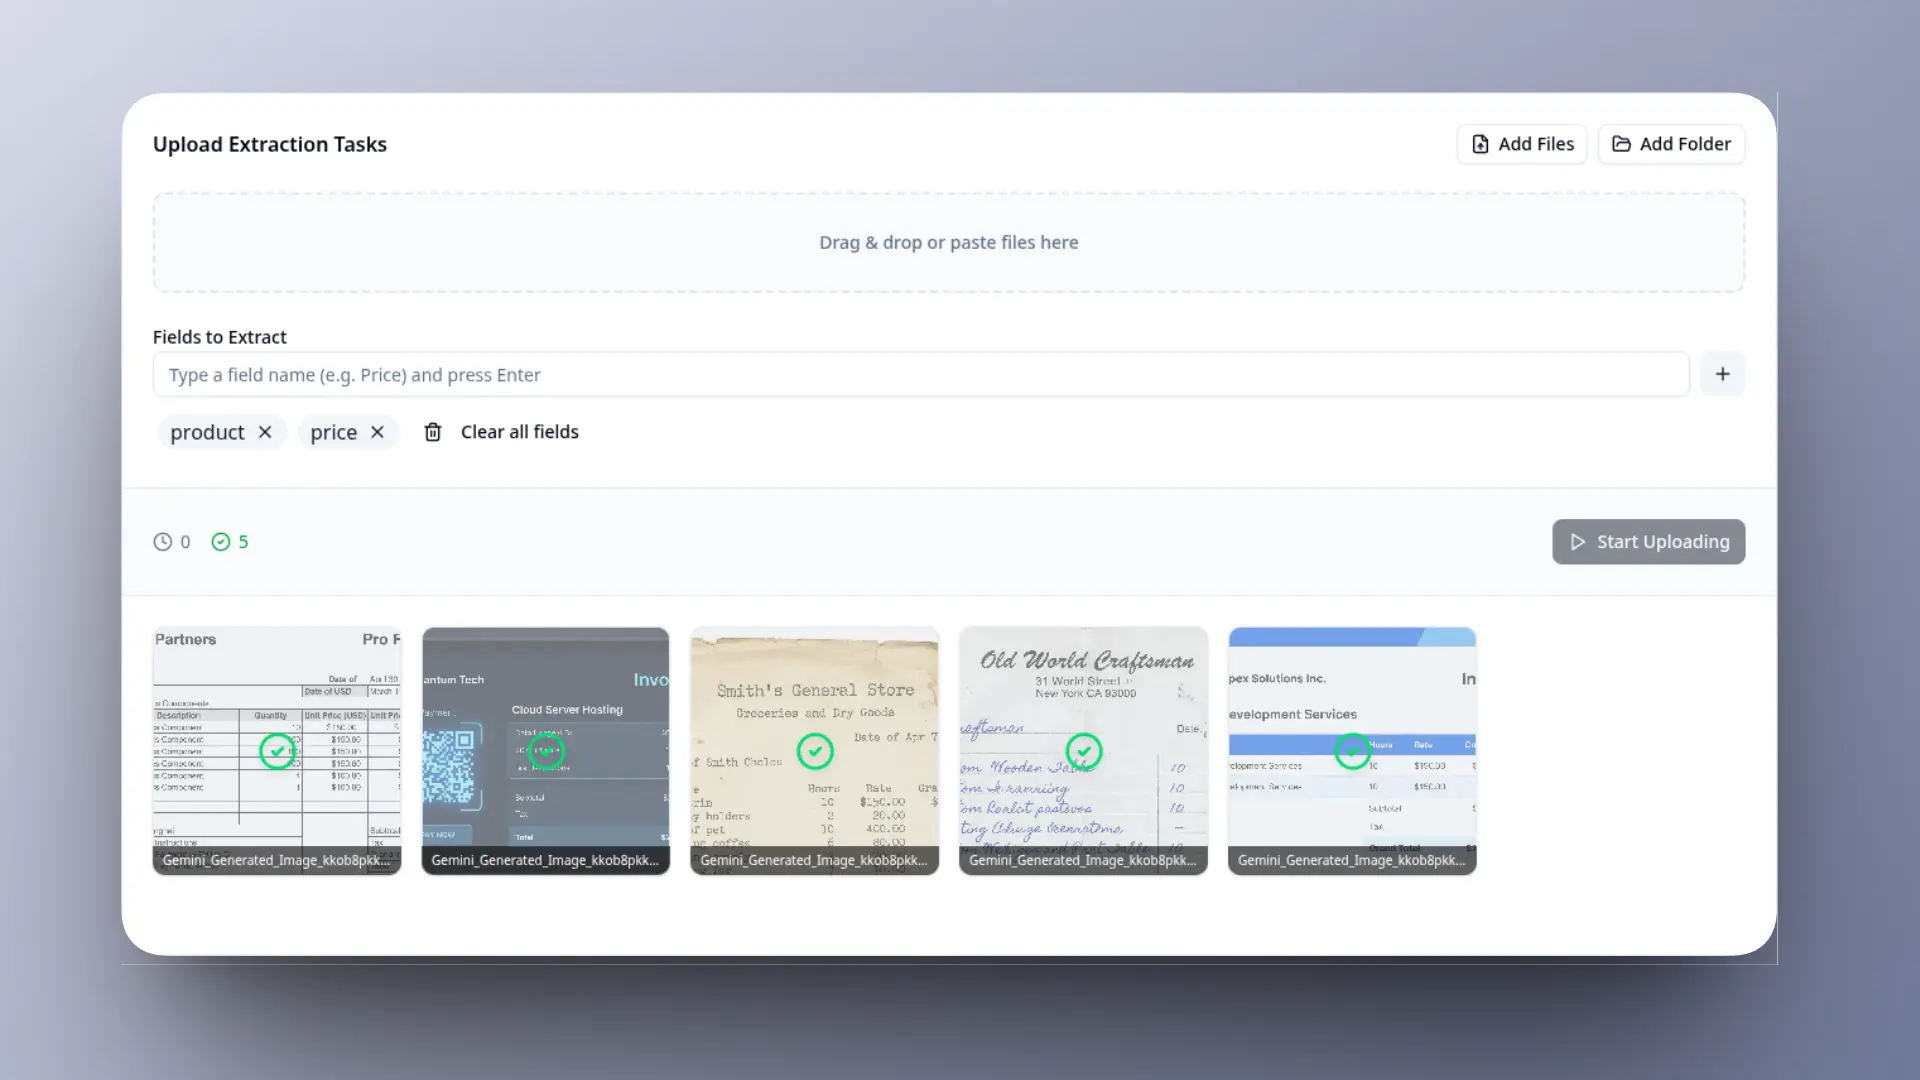
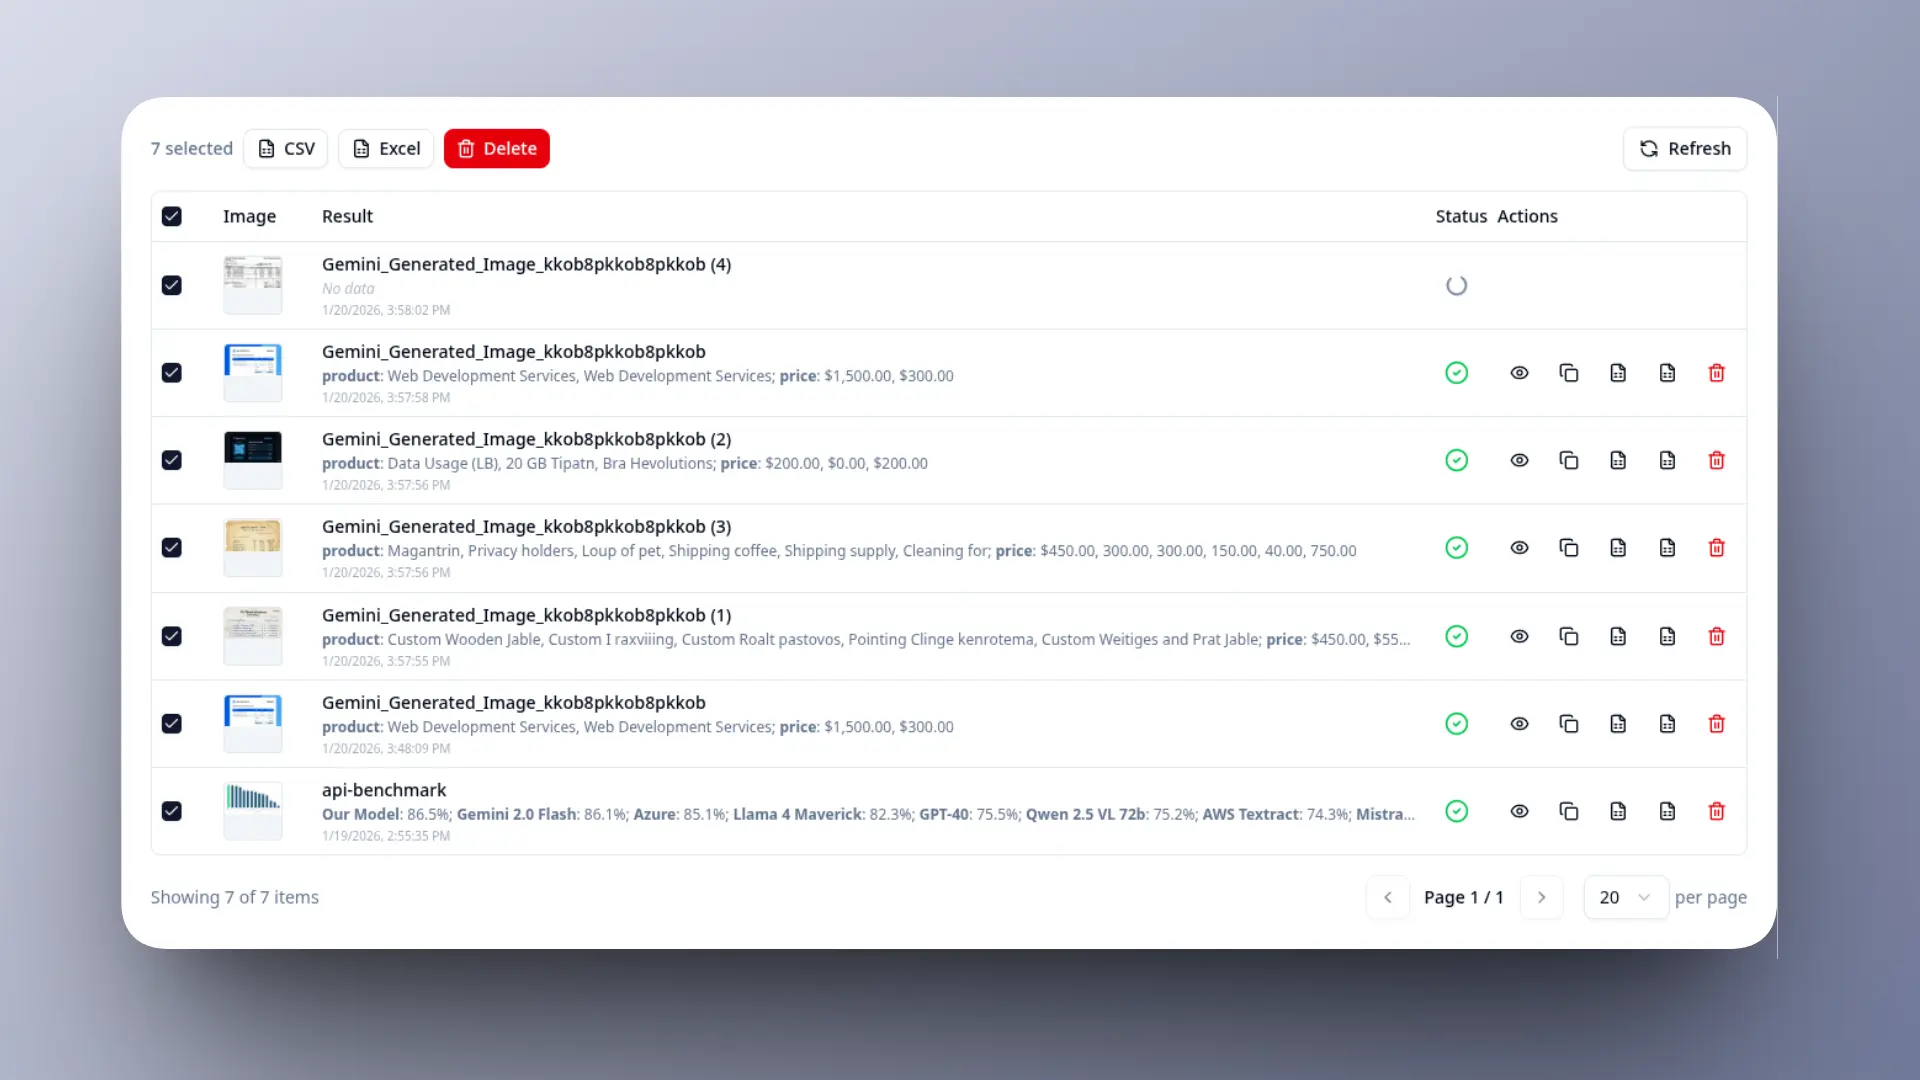
L’espace de travail par lot réunit la définition des champs, le traitement de plusieurs images et l’historique par fichier dans un workflow reproductible d’extraction de données documentaires.

Espace de travail d’importation d’images de documents par lot avec une liste de champs partagée
Ajoutez plusieurs images de documents et définissez les champs à demander dans chaque fichier.
Historique d’extraction de documents avec résultats et actions d’exportation par fichier
Vérifiez le statut et les valeurs extraites de chaque fichier, puis copiez ou téléchargez les résultats dont vous avez besoin.
ESPACE DE TRAVAIL PAR LOT

Traiter les tâches documentaires récurrentes par lot

Pour les ensembles de documents récurrents, appliquez une liste de champs à plusieurs images et conservez chaque résultat dans l’historique des extractions.

  • Une liste de champs pour le lotDéfinissez les champs demandés avant de traiter les fichiers.
  • Statut et historique par fichierConsultez les tâches terminées, en cours ou en échec et relancez celles qui ont échoué.
  • Copie et exportations CSV et ExcelTéléchargez les résultats par fichier ; les sélections plus importantes peuvent être regroupées dans un ZIP.

Choose a Path

Choisir le workflow d’extraction de documents adapté

Choisissez le parcours qui correspond au volume et à la fréquence de la tâche.

Use Cases

Des documents métier transformés en données par champ

Factures et reçus

Demandez le fournisseur, le numéro du document, la date, la devise, la taxe, le sous-total et le total.

Formulaires et demandes

Demandez les noms, dates, numéros de référence, adresses et certaines valeurs de formulaire.

Documents d’expédition et de logistique

Demandez les numéros de suivi, les coordonnées de l’expéditeur et du destinataire, les adresses et les références des colis.

Fiches de produits et de prix

Demandez les noms de produits, les identifiants, les prix affichés et les champs de catégorie visibles.

Documents d’identité et de contact

Demandez les noms visibles, les numéros de document, les entreprises, les dates et les coordonnées.

Rapports de recherche et d’exploitation

Demandez des indicateurs précis, des dates, des identifiants et des valeurs à vérifier ou à importer ultérieurement.

Choose a Tool

OCR, extraction de tableaux ou extraction de données documentaires ?

Choisissez selon la structure requise par votre processus en aval, et pas uniquement selon le document source.

Structured Output

Des résultats structurés pour l’étape suivante

Vérifiez les données dans l’interface ou transférez-les vers une feuille de calcul, une application ou un processus d’importation ultérieur.

Résultats d’une image unique

Affichez les champs à l’écran, copiez un ou tous les résultats et téléchargez un fichier CSV ou XLSX.

Historique du lot par fichier

Conservez un résultat distinct pour chaque image traitée et téléchargez les fichiers sélectionnés séparément ou dans un ZIP.

Réponses de l’API

Recevez par défaut un objet de résultat JSON, avec des options de réponse CSV et XLSX sur demande.

Intégrer la vérification aux workflows importants

L’extraction de données accepte actuellement les images de documents, mais pas les fichiers PDF. La qualité des images et les variations de mise en page peuvent affecter les résultats ; vérifiez donc les données financières, d’identité ou opérationnelles importantes avant toute utilisation en aval. L’historique des lots conserve les résultats par fichier au lieu de fusionner tous les documents dans une seule feuille de calcul.

FAQ

FAQ sur l’extraction de données documentaires par IA

Qu’est-ce que l’extraction de données documentaires par IA ?

L’extraction de données documentaires par IA identifie les champs demandés par l’utilisateur et renvoie leurs valeurs à partir d’images de documents. Elle est conçue pour produire des résultats par champ, et non pour reconstruire entièrement la page.

Quelle est la différence entre l’extraction de données documentaires et l’OCR ?

L’OCR convient à la récupération de tout le texte visible. L’extraction de données documentaires convient à certaines valeurs comme le fournisseur, la date, le numéro de document, le numéro de suivi ou le total.

Puis-je définir les champs nécessaires à mon workflow ?

Oui. Saisissez vos propres noms de champs sous forme de liste simple. Le workflow actuel utilise des noms de champs à un seul niveau plutôt qu’un schéma JSON typé ou imbriqué.

Les mêmes champs peuvent-ils être appliqués à plusieurs documents ?

Oui. L’espace de travail par lot applique une liste de champs à chaque image du lot et stocke un statut et un résultat distincts pour chaque fichier.

Existe-t-il une API d’extraction de données documentaires ?

Oui. L’API authentifiée accepte une image avec des noms de champs et renvoie du JSON par défaut, avec des options de réponse CSV ou XLSX. Les requêtes API utilisent des crédits API payants.

Les données extraites des documents doivent-elles être vérifiées ?

Oui. La netteté de l’image et la mise en page du document influencent l’extraction ; les valeurs importantes doivent donc être vérifiées avant tout paiement, reporting, import ou autre action en aval.

Choisissez comment poursuivre le traitement de vos documents

Testez une image de document, traitez un lot récurrent ou connectez l’extraction de champs documentaires à votre application.

Logiciel d’extraction de données documentaires par IA | FreeOCR.AI