Workflow voor documentverwerking

AI-gegevensextractie uit documenten voor bedrijfsworkflows

Zet terugkerende facturen, bonnen, formulieren, labels en andere documentafbeeldingen om in de bedrijfsvelden die uw team nodig heeft. Begin met één afbeelding, verwerk een batch met één veldlijst of maak verbinding via de API.

The Challenge

Verschillende documenten. Dezelfde bedrijfsvragen.

Documentlay-outs verschillen per leverancier, formulier of bron. Uw workflow heeft nog steeds consistente velden nodig die kunnen worden gecontroleerd en gebruikt.

Wie heeft het uitgegeven? Welk document is het? Wanneer is het opgesteld en wat is het totaal?

De software van FreeOCR.AI voor gegevensextractie uit documenten richt zich op gevraagde waarden in plaats van elke tekstregel terug te geven. Deze intelligente aanpak voor documentverwerking ondersteunt geautomatiseerde gegevensextractie uit documenten door voor elke afbeelding resultaten op veldniveau te retourneren.

Voorbeelden van bedrijfsvelden

LeverancierDocumentnummerDatumValutaBelastingTotaal

Workflow

Een geautomatiseerde workflow voor gegevensextractie uit documenten

Een eenvoudige workflow voor herhaalde documentverwerking zonder sjablonen met vaste coördinaten.

01

Documentafbeeldingen verzamelen

Voeg een factuur, bon, formulier, label of een andere ondersteunde documentafbeelding toe. Gebruik de tool voor één afbeelding voor eenmalige taken of de werkruimte voor ingelogde gebruikers voor meerdere bestanden.

02

De velden één keer definiëren

Voer de veldnamen in die uw proces nodig heeft. In een batch wordt dezelfde veldlijst op elke afbeelding toegepast, ook als de documentlay-outs verschillen.

03

Resultaten controleren en gegevens doorsturen

Controleer elk resultaat, kopieer waarden, download spreadsheetbestanden of vraag via de API een gestructureerd antwoord op voor de volgende verwerkingsstap.

In Practice

Eén veldlijst voor een hele documentbatch

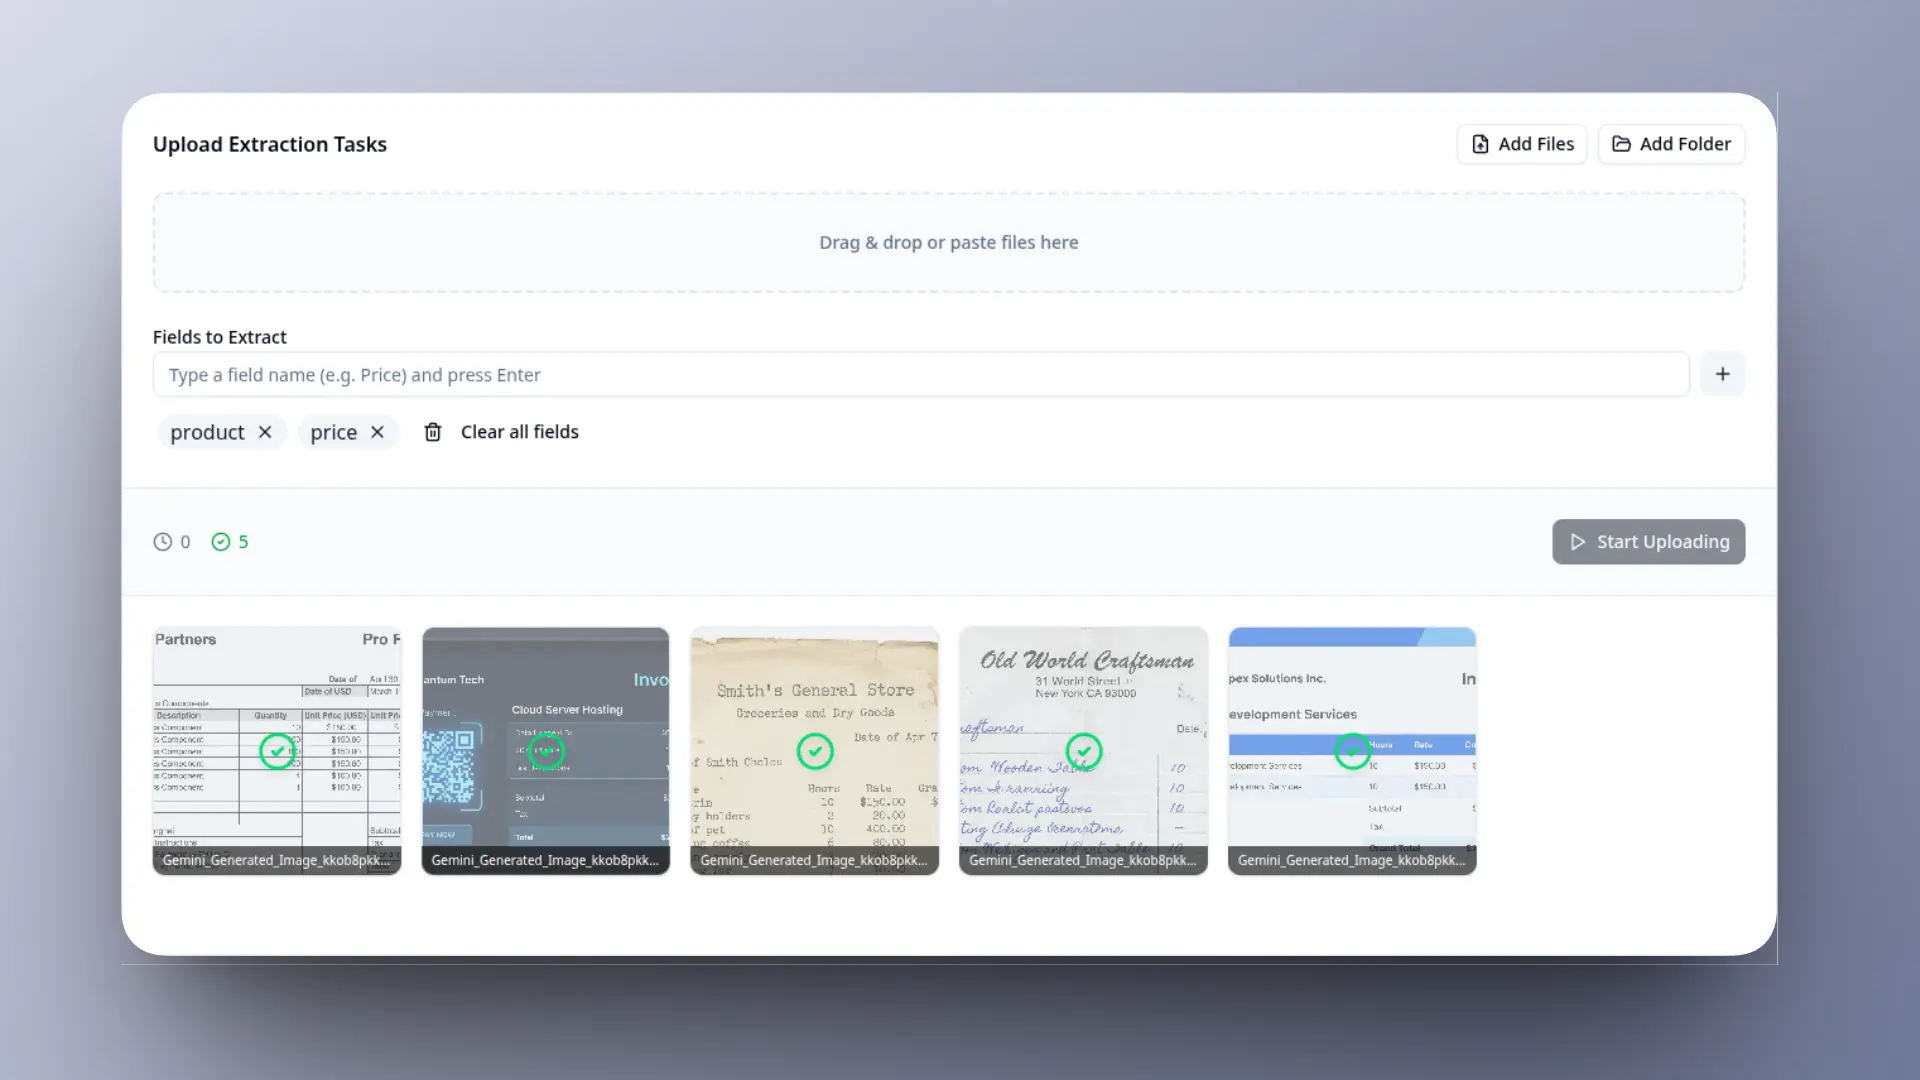
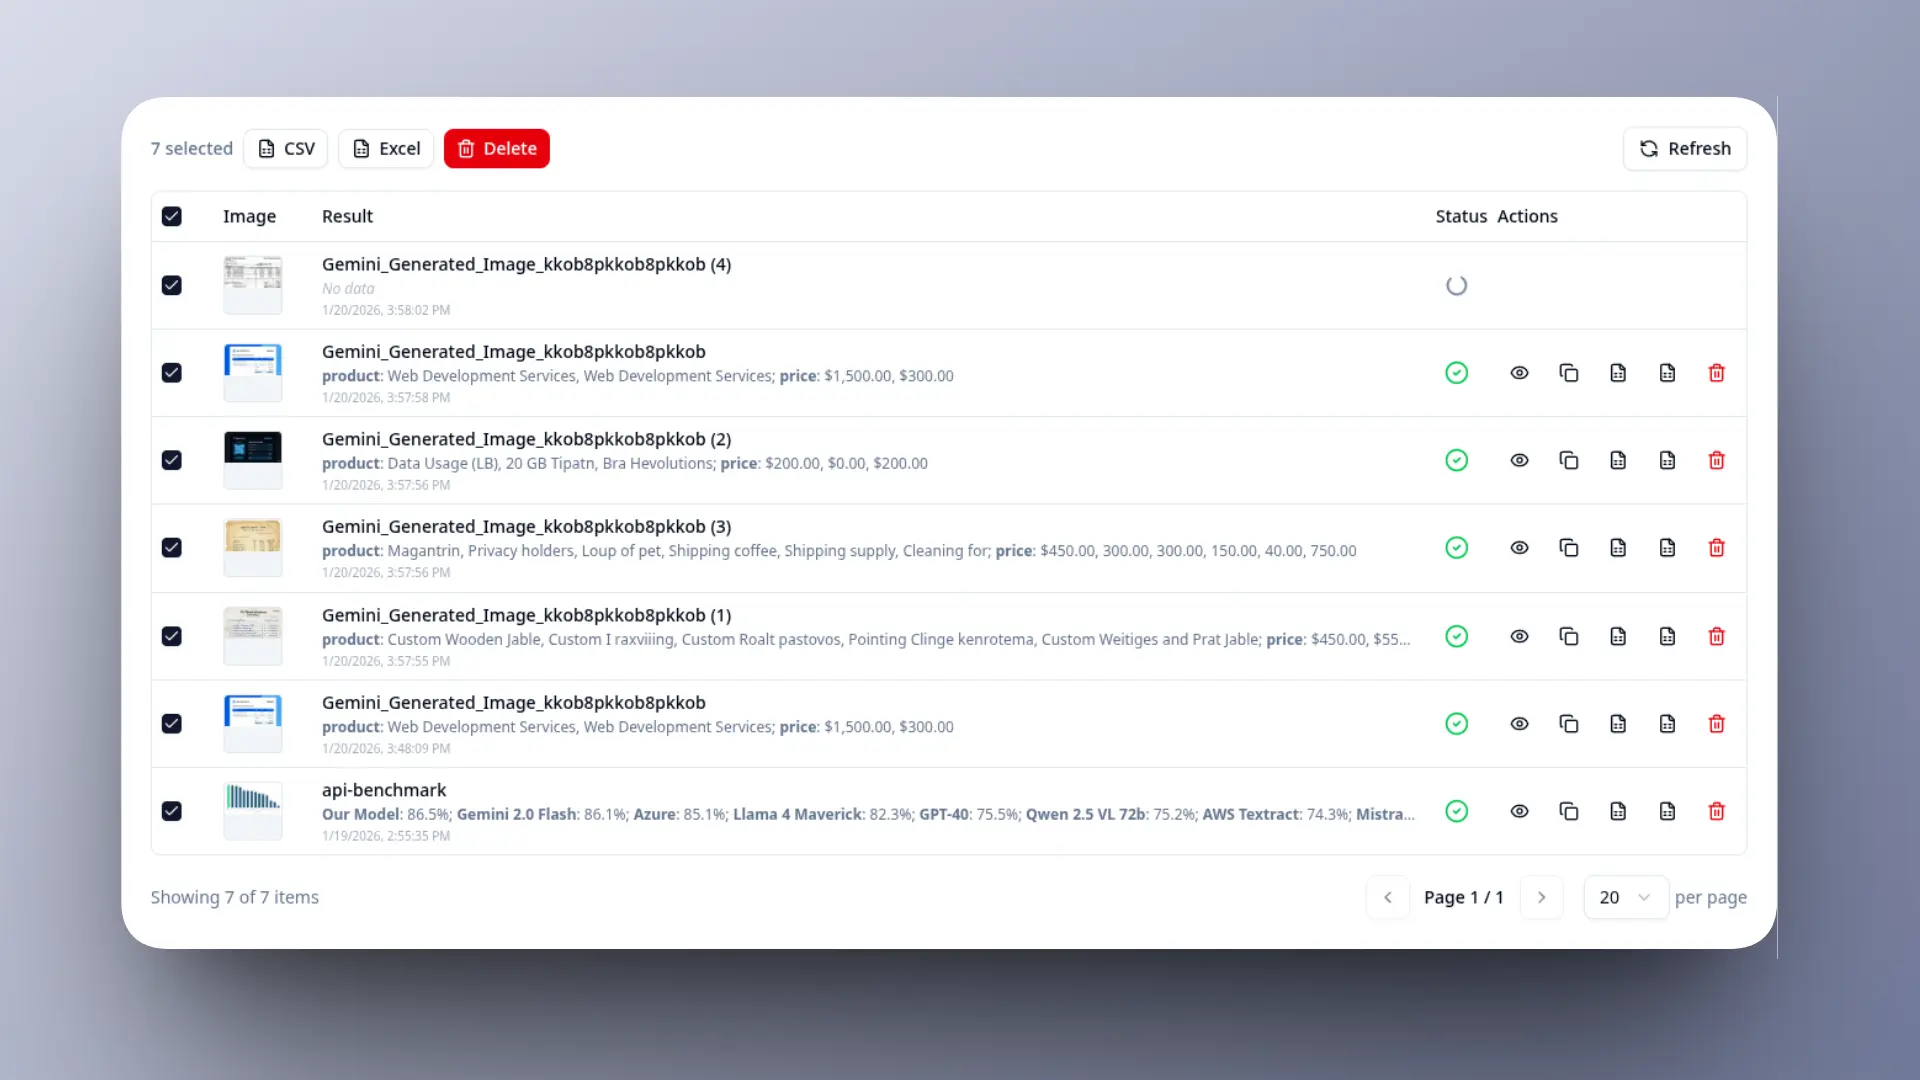
De bulkwerkruimte combineert velddefinitie, verwerking van meerdere afbeeldingen en geschiedenis per bestand in één herhaalbare workflow voor gegevensextractie uit documenten.

Werkruimte voor het uploaden van documentafbeeldingen in bulk met een gedeelde veldlijst
Voeg meerdere documentafbeeldingen toe en definieer de velden die uit elk bestand moeten worden opgevraagd.
Geschiedenis van documentextracties met resultaten en exportacties per bestand
Controleer de status en geëxtraheerde waarden per bestand en kopieer of download vervolgens de gewenste resultaten.
BATCHWERKRUIMTE

Verplaats terugkerend documentwerk naar een batch

Pas bij terugkerende documentsets één veldlijst toe op meerdere afbeeldingen en houd elk resultaat beschikbaar in de extractiegeschiedenis.

  • Eén veldlijst voor de batchDefinieer de gevraagde velden voordat de bestanden worden verwerkt.
  • Status en geschiedenis per bestandBekijk voltooide, actieve of mislukte taken en probeer mislukte taken opnieuw.
  • Kopiëren en exporteren naar CSV en ExcelDownload resultaten per bestand; grotere selecties kunnen in een ZIP worden verpakt.

Choose a Path

Kies de juiste workflow voor documentextractie

Kies de aanpak die past bij het volume en de herhaalbaarheid van het werk.

Use Cases

Bedrijfsdocumenten omzetten in gegevens op veldniveau

Facturen en bonnen

Vraag leverancier, documentnummer, datum, valuta, belasting, subtotaal en totaal op.

Formulieren en aanvragen

Vraag namen, datums, referentienummers, adressen en geselecteerde formulierwaarden op.

Verzend- en logistieke documenten

Vraag trackingnummers, gegevens van afzender en ontvanger, adressen en pakketreferenties op.

Product- en prijsregistraties

Vraag productnamen, identificatiecodes, vermelde prijzen en zichtbare categorievelden op.

Identiteits- en contactgegevens

Vraag zichtbare namen, documentnummers, bedrijven, datums en contactgegevens op.

Onderzoeks- en operationele rapporten

Vraag benoemde statistieken, datums, identificatiecodes en waarden op voor controle of latere import.

Choose a Tool

OCR, tabelextractie of documentgegevensextractie?

Kies op basis van de structuur die uw vervolgproces nodig heeft, niet alleen op basis van het brondocument.

Structured Output

Gestructureerde uitvoer voor de volgende stap

Controleer de gegevens in de interface of stuur ze door naar een spreadsheet, applicatie of later importproces.

Resultaten van één afbeelding

Bekijk velden op het scherm, kopieer één of alle resultaten en download CSV of XLSX.

Batchgeschiedenis per bestand

Bewaar een afzonderlijk resultaat voor elke verwerkte afbeelding en download geselecteerde bestanden afzonderlijk of in een ZIP.

API-responsen

Ontvang standaard een JSON-resultaatobject, met op verzoek responsopties in CSV en XLSX.

Neem controle op in belangrijke workflows

Gegevensextractie accepteert momenteel documentafbeeldingen en geen PDF-bestanden. Beeldkwaliteit en veranderende lay-outs kunnen de resultaten beïnvloeden. Controleer daarom belangrijke financiële, identiteits- of operationele waarden voordat u ze verder gebruikt. In de batchgeschiedenis blijven resultaten per bestand bewaard en worden niet alle documenten in één spreadsheet samengevoegd.

FAQ

Veelgestelde vragen over AI-gegevensextractie uit documenten

Wat is AI-gegevensextractie uit documenten?

AI-gegevensextractie uit documenten identificeert door de gebruiker gevraagde velden en retourneert de waarden ervan uit documentafbeeldingen. De functie is ontworpen voor uitvoer op veldniveau, niet voor een volledige reconstructie van de pagina.

Hoe verschilt gegevensextractie uit documenten van OCR?

OCR is geschikt om alle zichtbare tekst op te halen. Gegevensextractie uit documenten is geschikt voor geselecteerde waarden zoals Leverancier, Datum, Documentnummer, Trackingnummer of Totaal.

Kan ik de velden definiëren die mijn workflow nodig heeft?

Ja. Voer uw eigen veldnamen in als een eenvoudige lijst. De huidige workflow gebruikt platte veldnamen in plaats van een getypeerd of genest JSON Schema.

Kunnen dezelfde velden op meerdere documenten worden toegepast?

Ja. De batchwerkruimte past één veldlijst toe op elke afbeelding in de batch en bewaart voor elk bestand een afzonderlijke status en een afzonderlijk resultaat.

Is er een API voor gegevensextractie uit documenten?

Ja. De geauthenticeerde API accepteert een afbeelding met veldnamen en retourneert standaard JSON, met responsopties in CSV of XLSX. API-aanvragen gebruiken betaalde API-credits.

Moeten geëxtraheerde documentgegevens worden gecontroleerd?

Ja. De helderheid van de afbeelding en de documentlay-out beïnvloeden de extractie. Controleer daarom belangrijke waarden vóór betaling, rapportage, import of een andere vervolgactie.

Kies hoe uw documenten verdergaan

Test één documentafbeelding, verwerk een terugkerende batch of koppel documentveldextractie aan uw applicatie.

AI-software voor gegevensextractie uit documenten | FreeOCR.AI