EXAMPLE
輸入與輸出範例
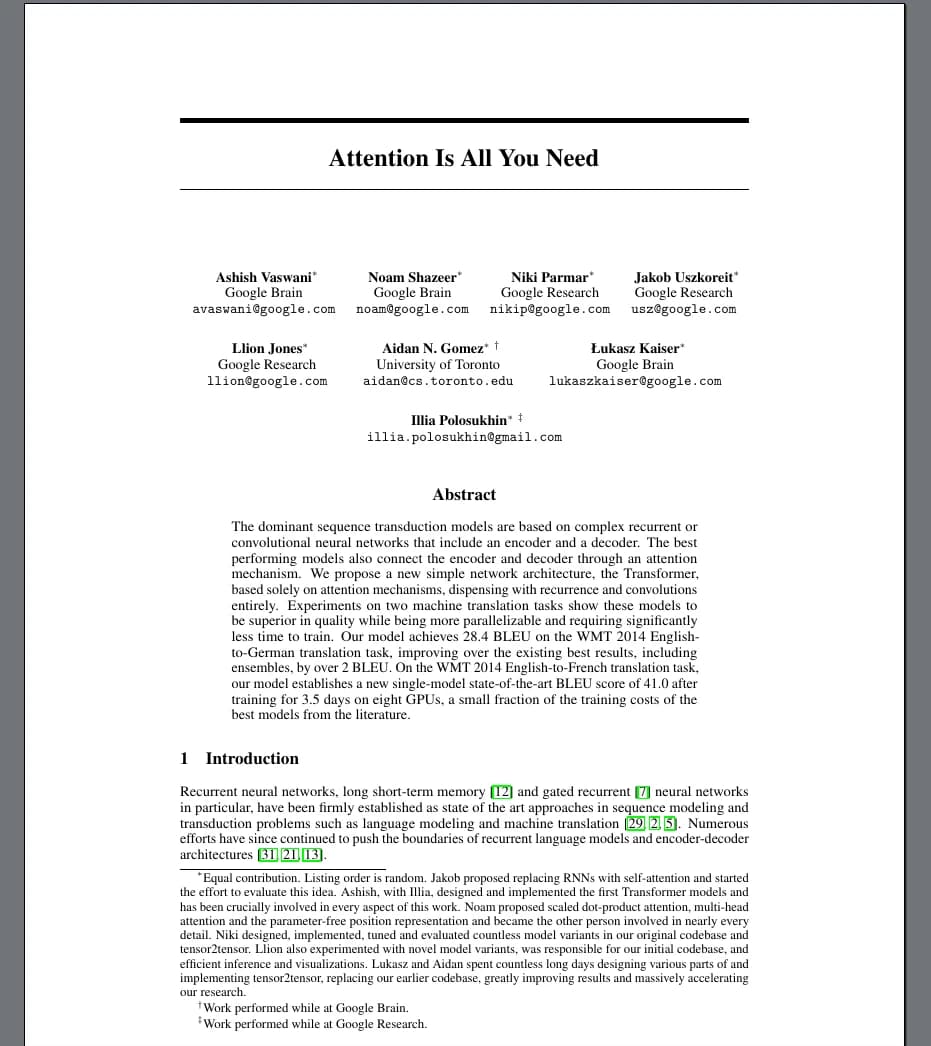
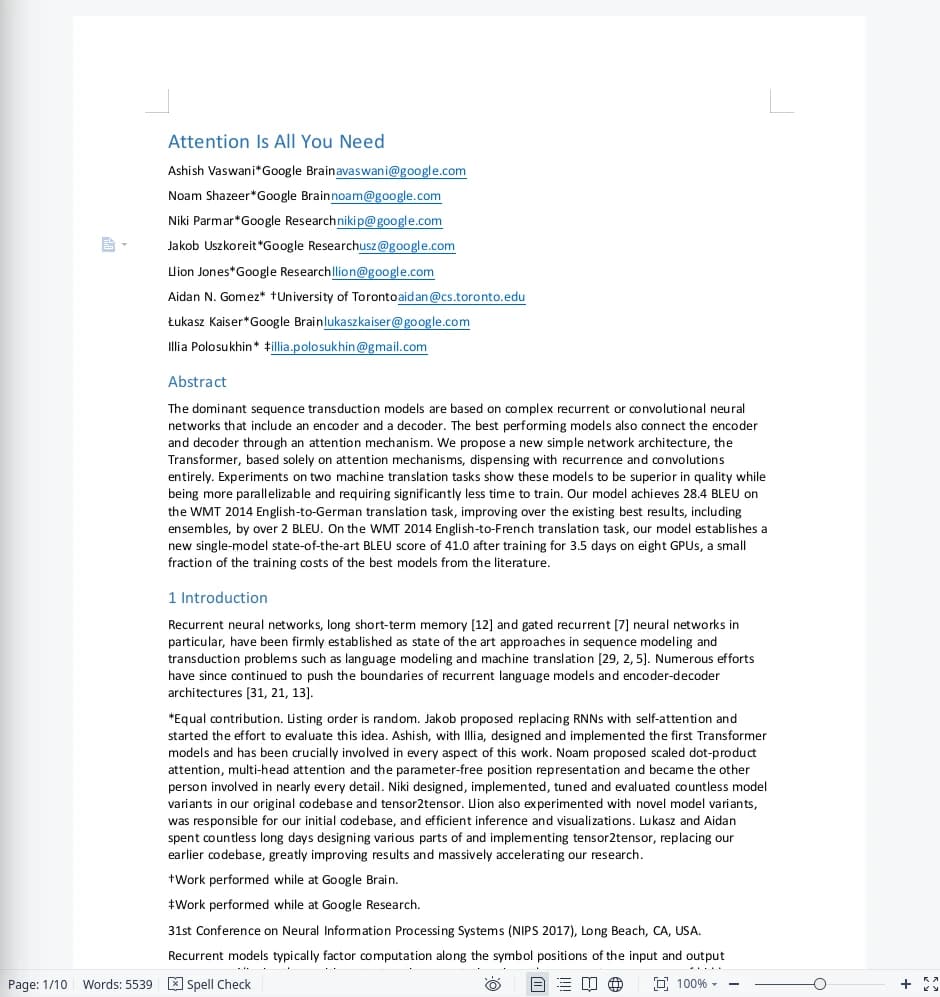
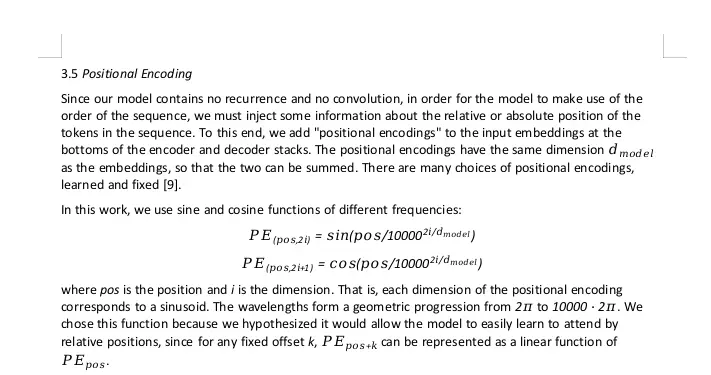
一個含表格與公式的掃描 PDF 頁面,被轉換為帶有原生表格與公式的可編輯 Word 文件。
PDF OCR
批次將掃描、純圖片型與受限 PDF 轉換為可編輯的 Word 文件。一次選擇多個 PDF 或整個資料夾,讓 FreeOCR Desktop 把文字、表格與公式重建為 Word 原生物件。
完整 PDF 轉換在 FreeOCR Desktop 中進行,不在瀏覽器中處理,每頁消耗 1 積分。登入同一帳戶即可使用永久積分或訂閱積分,無需強制訂閱。
TYPES
並非每個 PDF 都保存了真正的文字。正確的轉換方式取決於檔案裡實際包含的內容。
PROCESS
FreeOCR 不只是提取字元。它把每一頁當作結構化文件來讀取,並把元素重建為 Word 原生物件。
CONTENT
OCR 轉 Word 的流程把掃描頁面變成 Word 原生、可編輯的元素——而不是純文字或靜態圖片。
段落、標題以及有序/無序清單會按層級還原。多欄內容按邏輯順序讀入,產生乾淨、線性的 Word 文件。
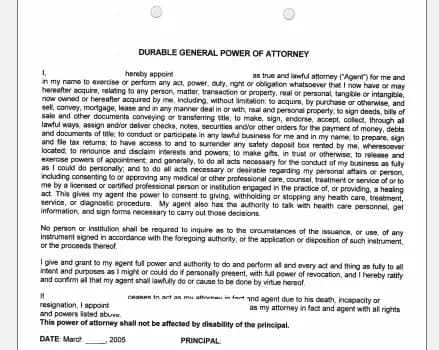
列、欄與儲存格被重建為真正的 Word 表格——你可以編輯數值、調整欄寬並重新設定儲存格格式。
區塊與行內數學被重建為 Word 原生公式,因此符號與變數保持可編輯,而不會變成純文字或圖片。
WORKFLOW
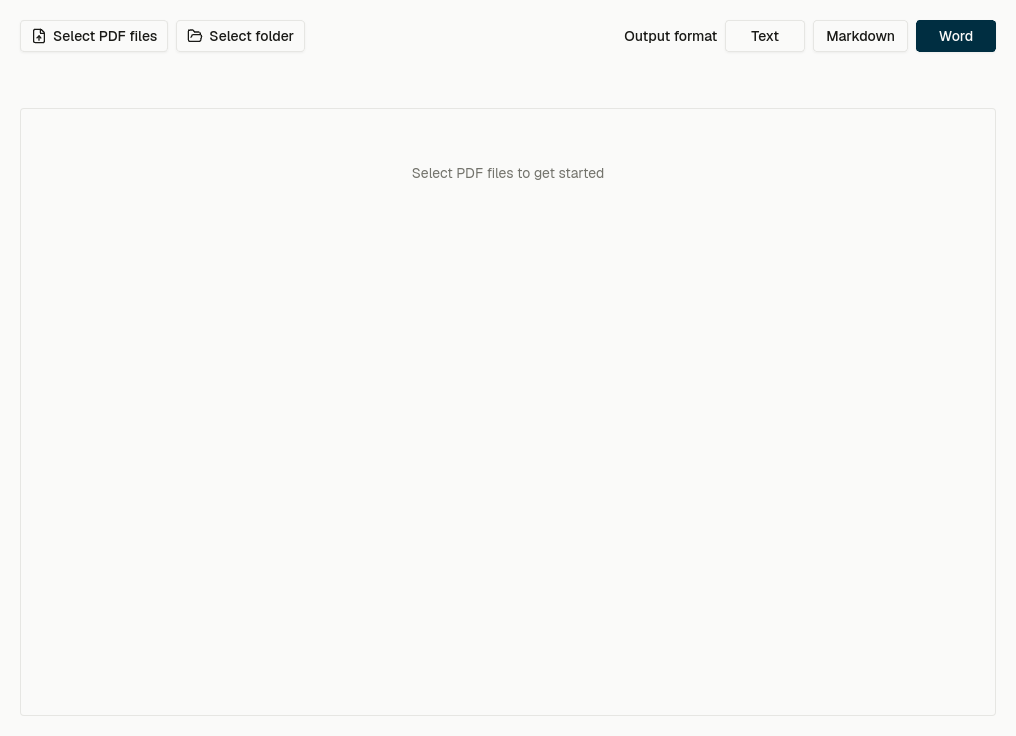
一次選擇多個 PDF 或整個資料夾,然後選擇 Word(.docx)作為輸出格式。Desktop 會在開始前顯示檔案數與總頁數。
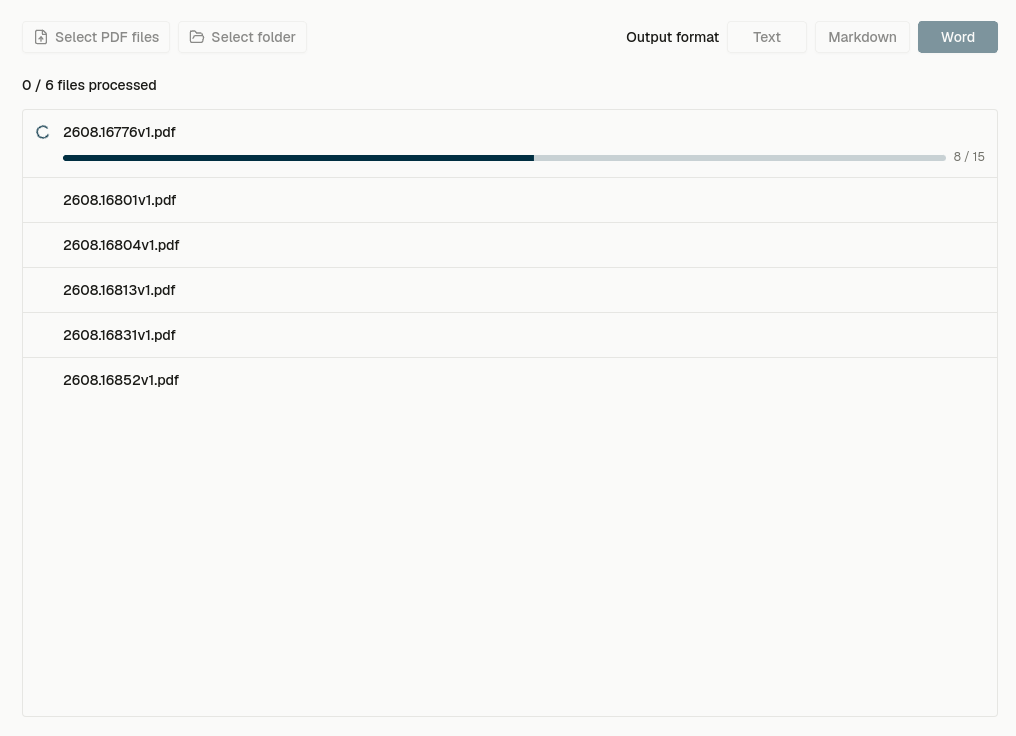
只需開始一次,即可查看每個檔案與頁面的進度。PDF 會依序處理,目前 PDF 內的頁面會併行辨識。
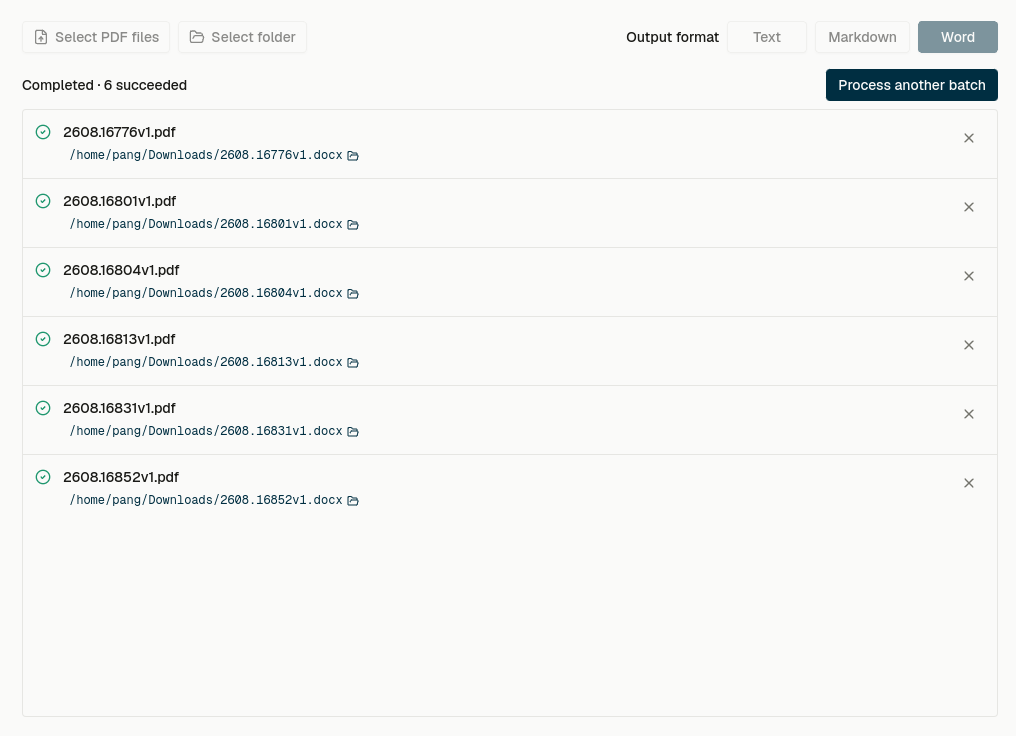
每個 PDF 都會分別儲存為可編輯的 .docx。可從已完成的檔案列開啟輸出位置,也可以重試失敗的檔案。
EXAMPLE
一個含表格與公式的掃描 PDF 頁面,被轉換為帶有原生表格與公式的可編輯 Word 文件。
BATCH
把多個 PDF 或整個資料夾加入同一個佇列。Desktop 會處理每份文件的所有頁面,無需手動逐一開始。
COMPARISON
同一個 AI OCR 引擎的兩個入口。選擇與你的來源相符的那個。
| 功能 | 圖片轉 Word(網頁) | PDF 轉 Word(桌面端) |
|---|---|---|
| 輸入 | 單張圖片(JPG、PNG、WEBP、HEIC) | 多個完整 PDF 或整個資料夾,逐頁處理 |
| 執行位置 | 在瀏覽器中 | FreeOCR Desktop 應用程式 |
| 批次與多頁 | 每次一張圖片(工作台可批次) | 一個批次處理多個 PDF,包含每個 PDF 的所有頁面 |
| 最適合 | 片段、截圖與相片 | 完整的掃描文件與報告 |
USES
把掃描 PDF 轉 Word 最能節省時間的情境。
QUALITY
OCR 效果首先取決於掃描件本身。開始批次處理前做好這些檢查,能幫助 AI 更穩定地讀取文字與結構。
REVIEW
FreeOCR Desktop 今天能做什麼、不能做什麼,如實說明。
RELATED
只需要文字時選擇文字,需要保留結構但不需要 DOCX 時選擇 Markdown。
FAQ
可以。掃描 PDF 是沒有真實文字層的頁面圖片,所以一般 PDF 轉 Word 工具讀不了。FreeOCR 用 AI OCR 辨識文字,並在 Desktop 應用程式中將其重建為可編輯的 Word 文件。
FreeOCR 把表格重建為真正可編輯的 Word 表格(含列、欄與儲存格),把數學重建為 Word 原生公式。效果取決於掃描的清晰度,但輸出保持可編輯,而不會變成純文字或靜態圖片。
可以。選擇多個 PDF 或整個資料夾,只需開始一次。Desktop 會處理每一頁,為每個 PDF 分別儲存輸出檔案,每頁消耗 1 點。
不能。完整的 PDF 轉 Word 在 FreeOCR Desktop 應用程式中執行,而不是瀏覽器。網頁端把圖片(JPG、PNG、WEBP、HEIC)轉為 Word。要處理整份掃描 PDF,請下載 Desktop。
圖片轉 Word 在瀏覽器中處理單張圖片或工作台中的圖片批次。PDF 轉 Word 在 Desktop 中批次處理完整 PDF,並為每個 PDF 分別產生輸出檔案。兩者使用同一個 AI OCR 引擎。
完整 PDF 轉換在 FreeOCR Desktop 中進行,不在瀏覽器中處理,每頁消耗 1 積分。登入同一帳戶即可使用永久積分或訂閱積分,無需強制訂閱。
下載 FreeOCR Desktop,加入多個 PDF 或整個資料夾,並為每個 PDF 分別匯出可編輯的 Word 文件。無需強制訂閱。
每頁 PDF 1 點 · Windows(x64、ARM64)· macOS