PDF를 텍스트 파일로 어떻게 변환하나요?
FreeOCR Desktop을 다운로드하고 하나 이상의 PDF를 선택한 뒤 출력 형식으로 텍스트를 선택하고 OCR를 시작하세요. Desktop은 원본 PDF마다 .txt 파일 하나를 저장합니다.
PDF OCR
AI OCR로 스캔본, 이미지 전용, 네이티브 PDF를 깔끔한 TXT 파일로 바꾸세요. 여러 문서 또는 폴더를 선택하고 모든 페이지를 처리하여 PDF마다 텍스트 파일 하나를 저장합니다.
전체 PDF 변환은 브라우저가 아닌 FreeOCR Desktop에서 실행되며 페이지당 1크레딧을 사용합니다. 같은 계정으로 로그인하여 영구 크레딧이나 구독 크레딧을 사용할 수 있으며, 구독은 필수가 아닙니다.
PDF TYPES
원본 PDF에 선택 가능한 텍스트가 있든 스캔 이미지만 있든 FreeOCR는 각 페이지의 보이는 내용을 읽습니다.
PLAIN TEXT
TXT는 시각적 서식을 의도적으로 제거하여 열기, 복사, 검색 및 재사용이 쉬운 가벼운 텍스트를 제공합니다.
WORKFLOW
완전한 PDF 문서와 반복적인 일괄 작업에는 데스크톱 앱을 사용하세요.
PDF 파일 또는 폴더 선택
출력 형식으로 텍스트 선택
OCR 실행 후 .txt 파일 저장
PRODUCT PROOF
PDF 선택부터 문서별 TXT 파일 저장까지 실제 일괄 처리 과정을 확인하세요.
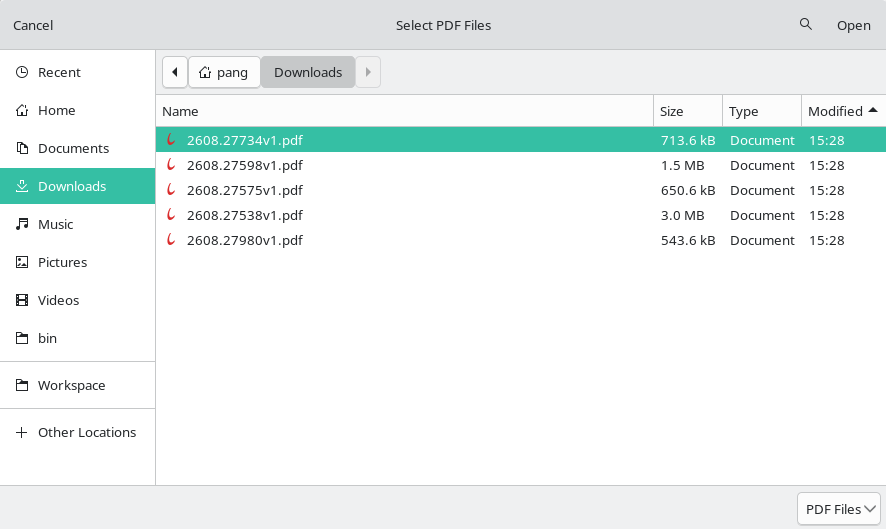
여러 PDF를 직접 선택하거나 폴더의 모든 PDF를 한 번에 추가할 수 있습니다.
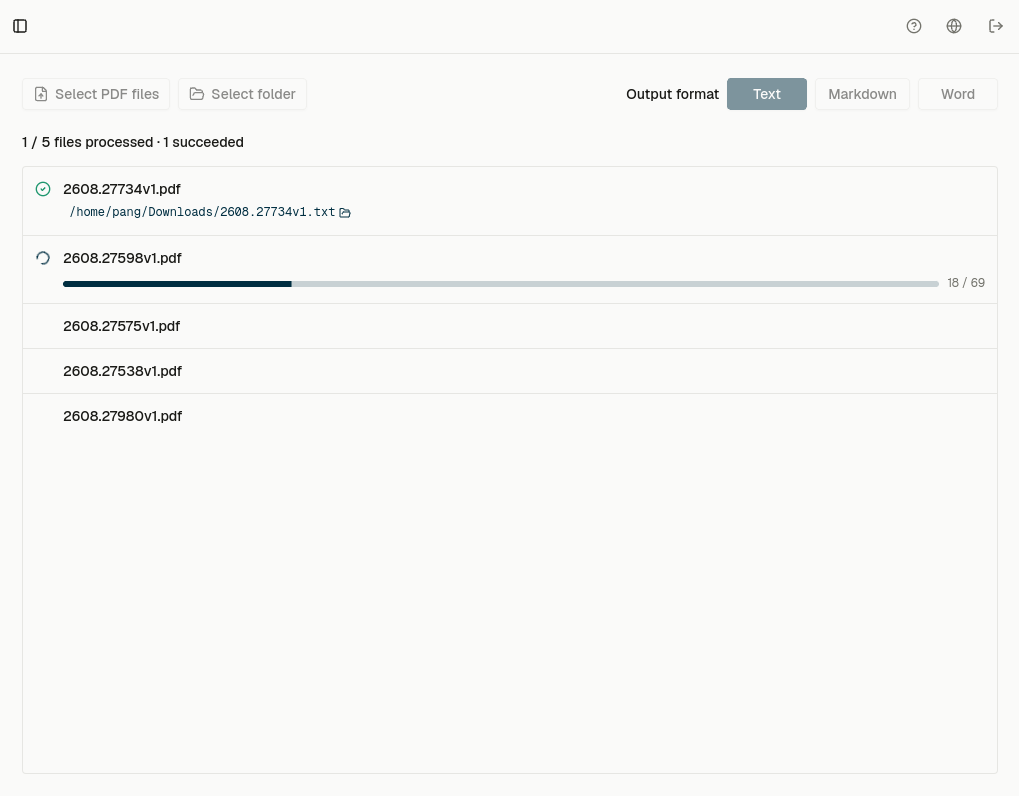
Desktop은 모든 페이지를 순서대로 처리하면서 파일과 페이지 진행률을 표시합니다.
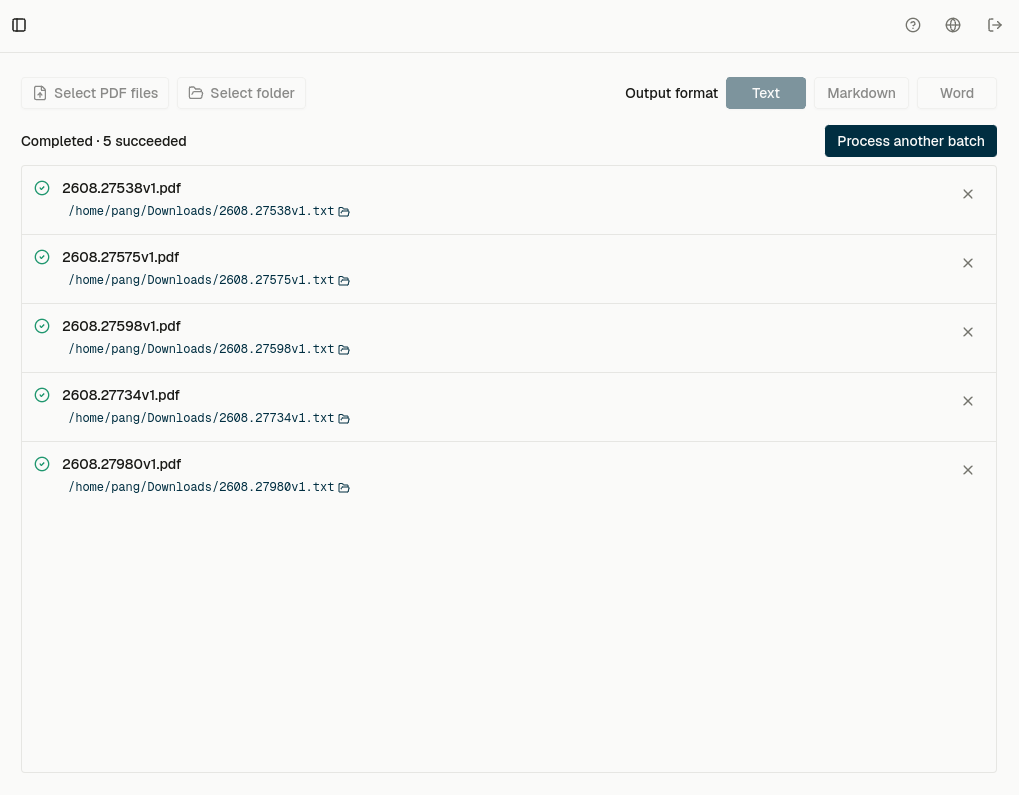
원본 문서마다 별도의 .txt를 만들어 파일명과 문서 경계를 명확하게 유지합니다.
EXAMPLE
양쪽에 같은 PDF 페이지를 사용해 TXT가 유지하는 내용과 제거하는 내용을 확인할 수 있게 하세요.
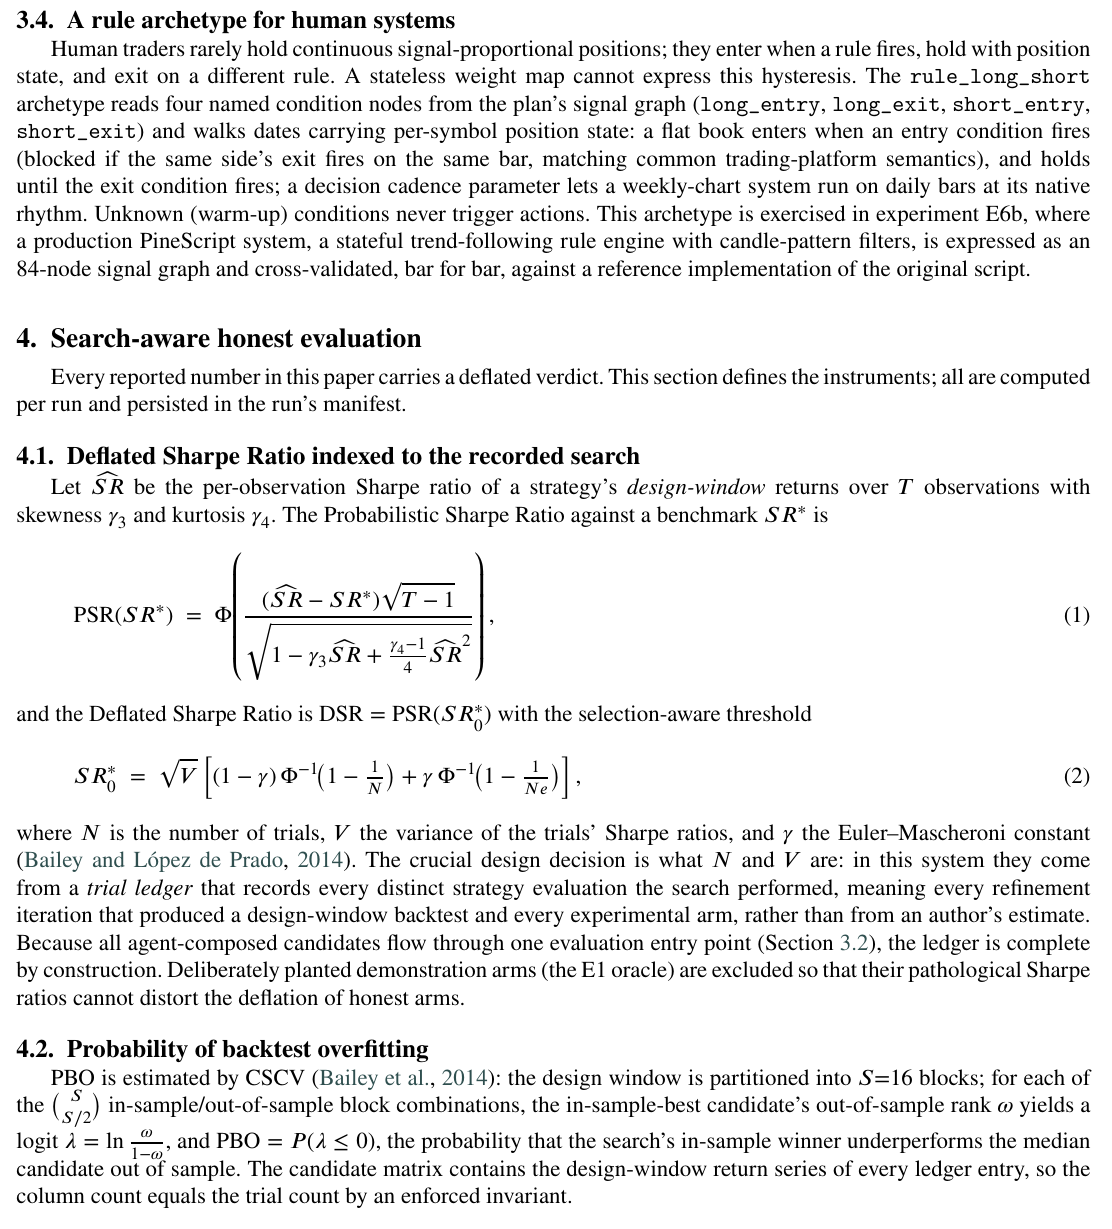
AI OCR가 일반 복사, 검색 및 텍스트 추출 도구로 읽을 수 없는 스캔 내용을 인식합니다.
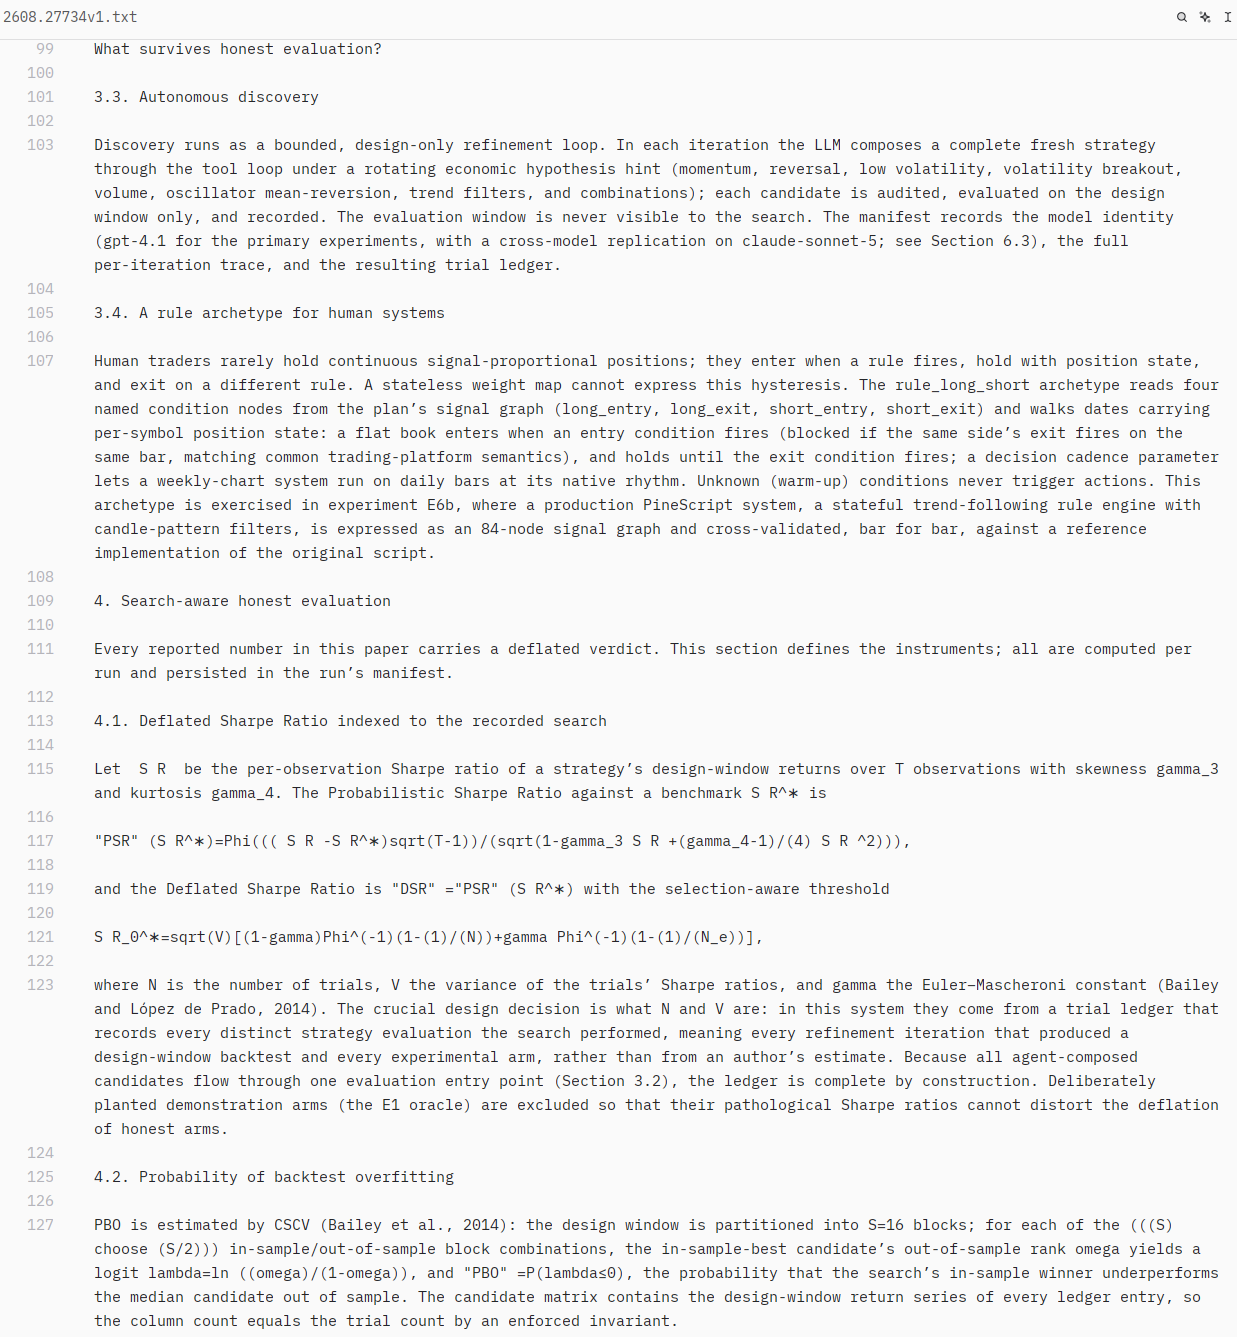
제목과 문단을 글꼴, 열, 페이지 스타일이 없는 읽기 쉬운 텍스트 블록으로 만듭니다.
BATCH
문서를 하나씩 업로드하고 다운로드하지 말고 배치를 한 번 준비하면 Desktop이 순서대로 처리합니다.
USES
원래 디자인보다 내용이 더 중요할 때 TXT를 선택하세요.
LIMITS
TXT는 의도적으로 단순합니다. 더 풍부한 문서 구조가 필요하면 Markdown 또는 Word를 선택하세요.
RELATED
같은 Desktop PDF 워크플로에서 다음 단계에 맞는 출력 형식을 선택하세요.
FAQ
FreeOCR Desktop을 다운로드하고 하나 이상의 PDF를 선택한 뒤 출력 형식으로 텍스트를 선택하고 OCR를 시작하세요. Desktop은 원본 PDF마다 .txt 파일 하나를 저장합니다.
예. FreeOCR는 모든 페이지를 렌더링하고 AI OCR를 사용하므로 선택 가능한 텍스트가 없는 스캔본과 이미지 전용 PDF도 읽을 수 있습니다.
일반 텍스트는 인식된 글자와 기본 읽기 순서를 유지하지만 글꼴, 이미지, 열 또는 페이지 레이아웃은 보존하지 않습니다. 구조와 서식이 중요하면 PDF to Markdown 또는 PDF to Word를 사용하세요.
예. 여러 PDF 또는 폴더를 선택하세요. Desktop은 문서를 순서대로 처리하고 활성 PDF의 페이지는 병렬로 처리한 뒤 PDF마다 별도 텍스트 파일을 저장합니다.
전체 PDF 변환은 브라우저가 아닌 FreeOCR Desktop에서 실행됩니다. 데스크톱 워크플로는 여러 페이지 PDF와 여러 파일 배치를 위해 설계되었습니다.
전체 PDF 변환은 브라우저가 아닌 FreeOCR Desktop에서 실행되며 페이지당 1크레딧을 사용합니다. 같은 계정으로 로그인하여 영구 크레딧이나 구독 크레딧을 사용할 수 있으며, 구독은 필수가 아닙니다. Desktop은 처리 전에 페이지 수를 표시하고 사용 가능한 크레딧을 확인합니다.
FreeOCR Desktop을 다운로드하고 PDF를 추가한 뒤 AI OCR로 깔끔한 .txt 파일을 내보내세요.
PDF 페이지당 1크레딧 · 여러 PDF 및 폴더 지원