如何把 PDF 转成 Markdown?
下载 FreeOCR 桌面端,选择一个或多个 PDF 文件,将输出格式设为 Markdown,然后开始 OCR。每个源 PDF 会保存为一个 .md 文件。
PDF OCR
选择多个 PDF 或整个文件夹。FreeOCR 桌面端可处理扫描版、纯图片和多页文档,识别标题、列表、表格和公式,并为每个 PDF 保存一个可编辑的 .md 文件。
完整 PDF 转换在 FreeOCR Desktop 中进行,不在浏览器中处理,每页消耗 1 积分。登录同一账户即可使用永久积分或订阅积分,无需强制订阅。
PDF TYPES
FreeOCR 会渲染并识别每一页的可见结构,因此无论 PDF 是否带有可选择的文本层都能处理。
MARKDOWN
输出会保留实用的文档结构,可直接用于编辑器、代码仓库和 AI 工作流。
WORKFLOW
使用桌面端直接处理完整 PDF,无需在浏览器里逐页上传。
选择 PDF 文件或文件夹
选择 Markdown 输出格式
运行 OCR 并保存 .md 文件
PRODUCT PROOF
这是一次真实的 FreeOCR 桌面端操作,从选择 PDF 到保存 Markdown 结果。
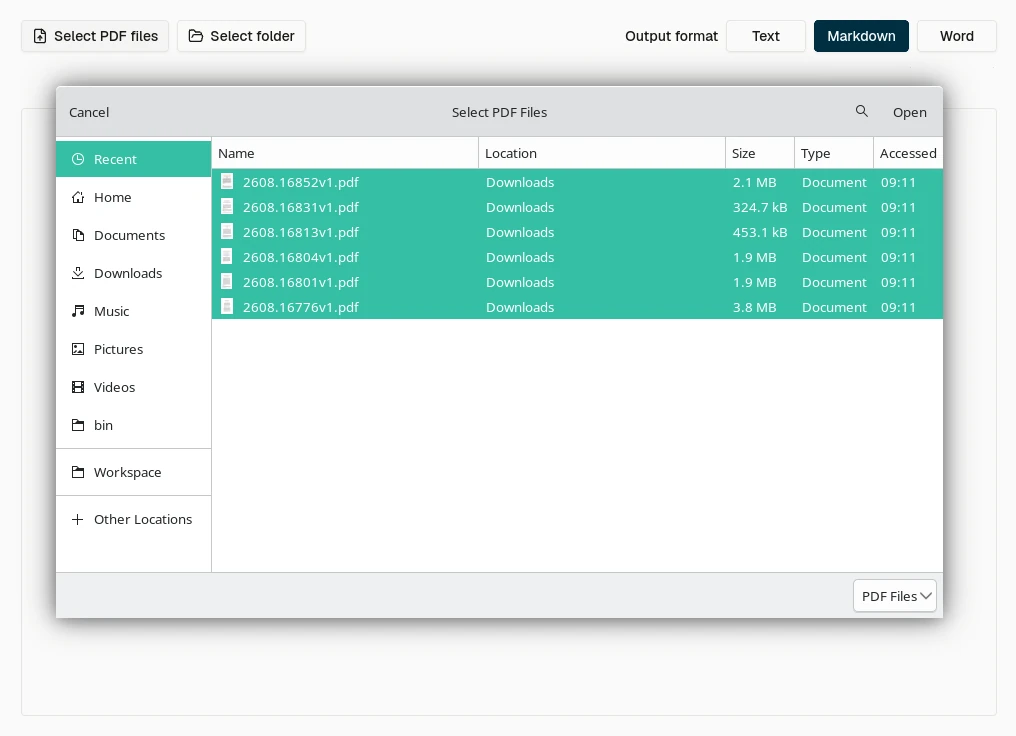
在 PDF OCR 界面一次选择多个 PDF,也可以直接添加整个文件夹。
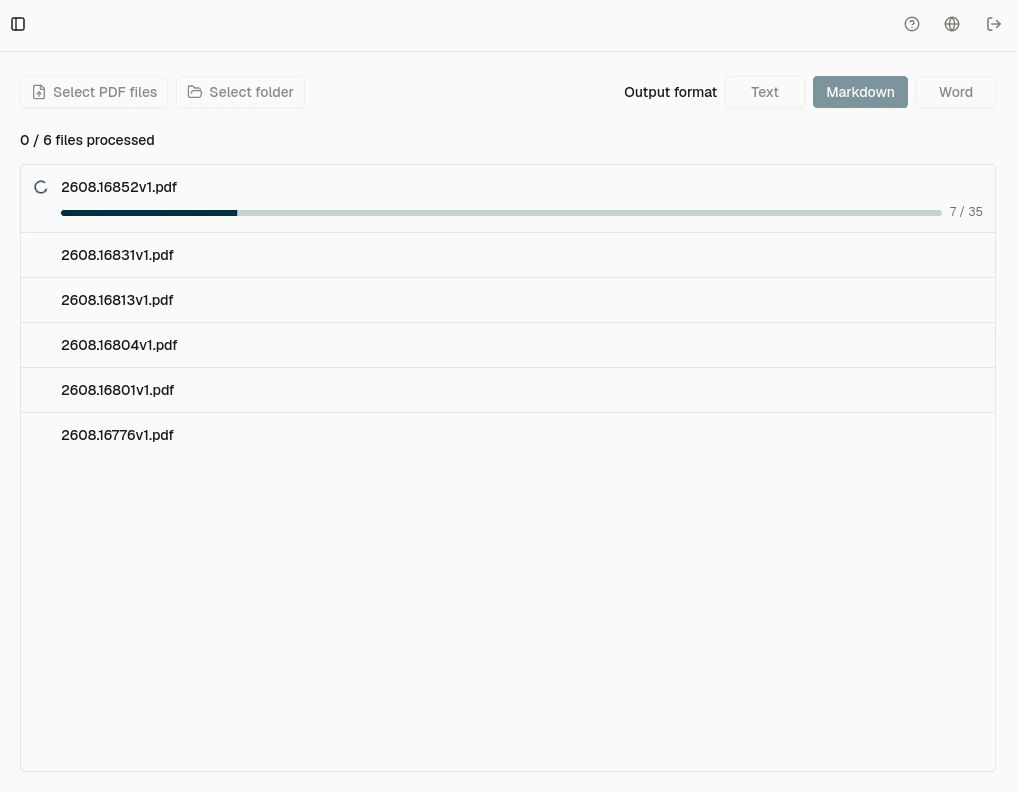
为整批文件选择一次 Markdown 格式,然后查看每份 PDF 的页面处理进度。
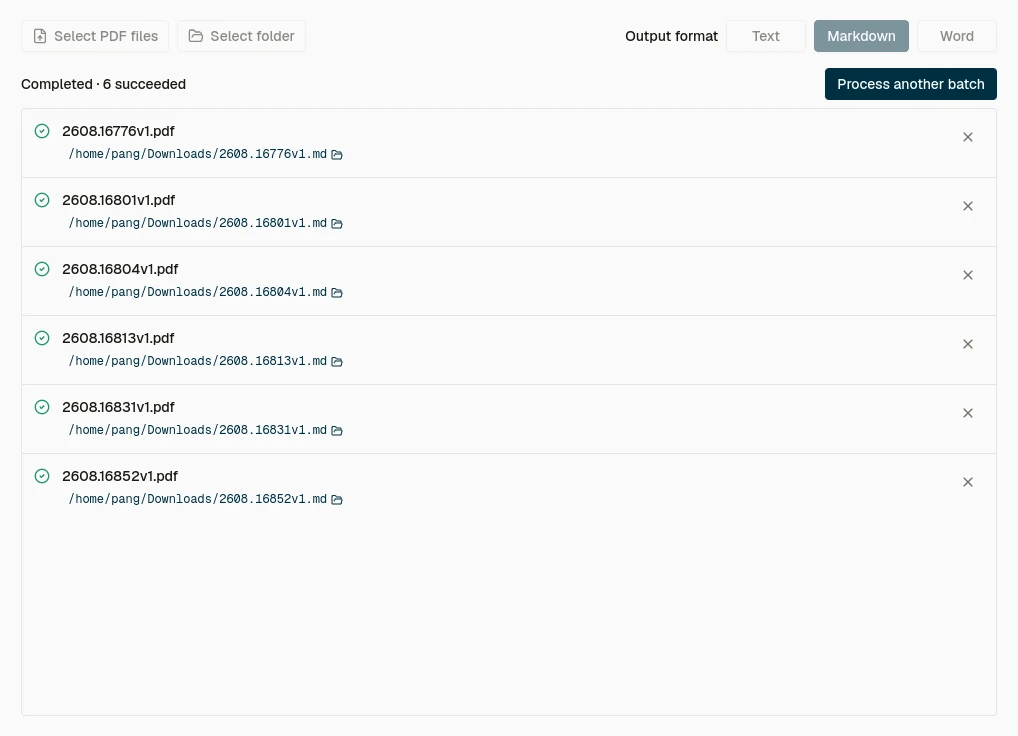
每份完成的 PDF 都会单独保存为 .md 文件,队列中会显示对应的输出路径。
EXAMPLE
同一页研究论文在 FreeOCR 桌面端处理前后的实际效果。
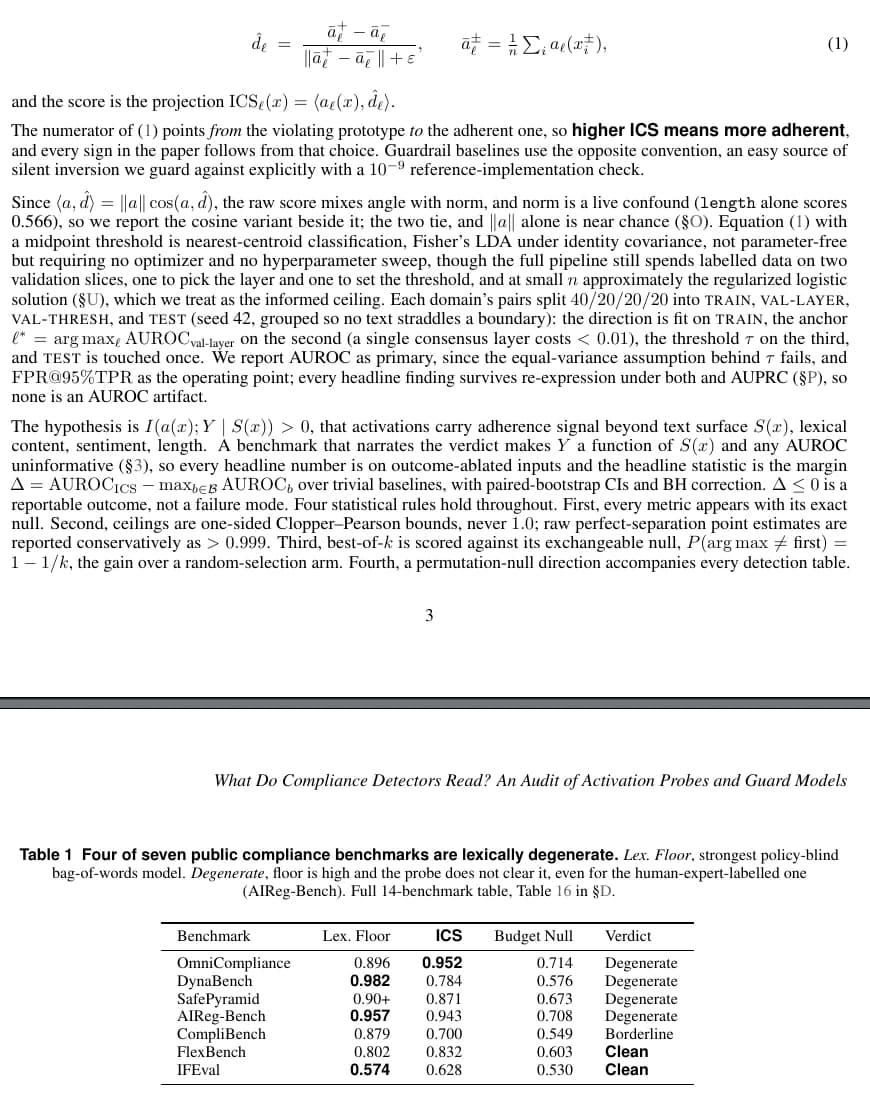
包含正文、数学公式和基准表格的源 PDF 页面。
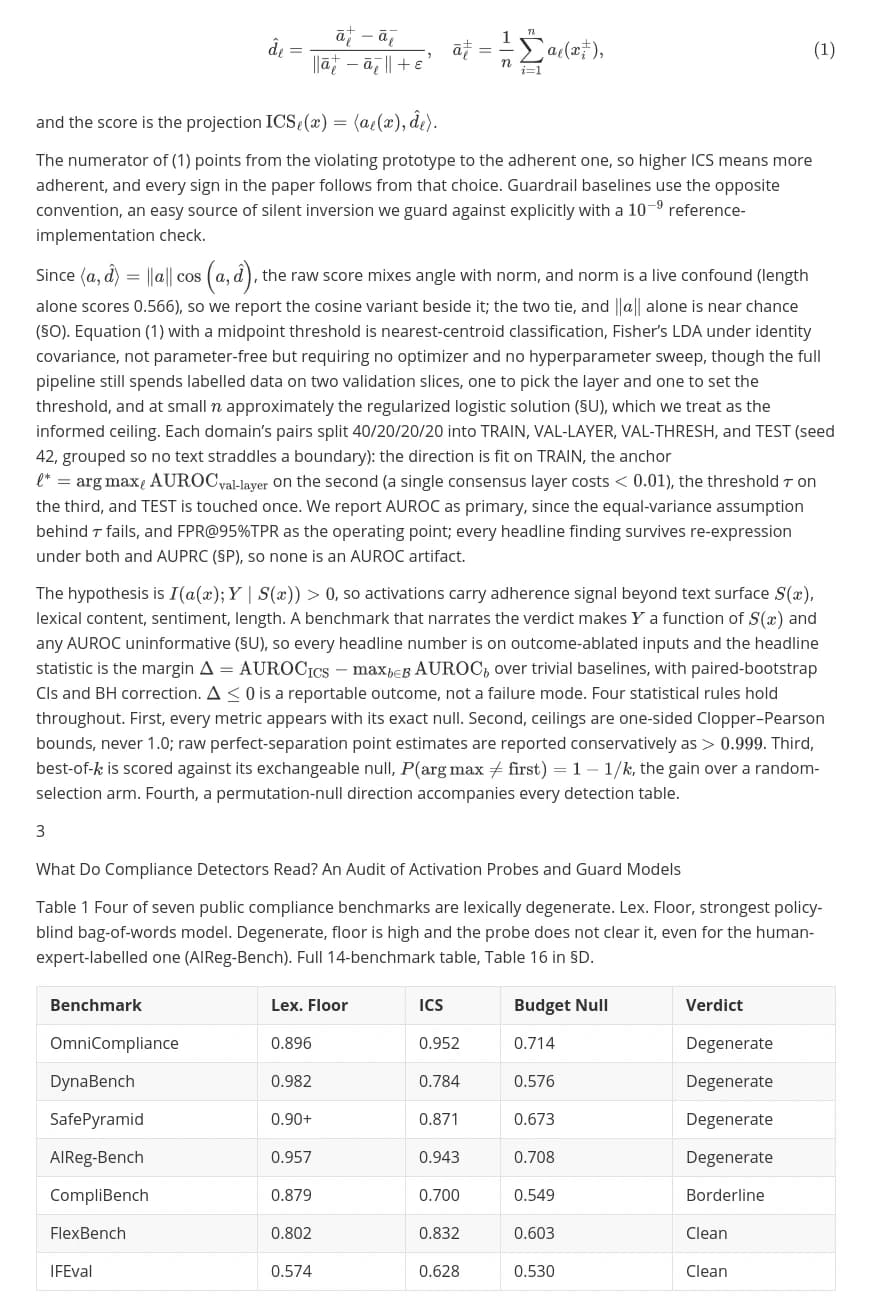
同一 PDF 页面的 Markdown 输出,保留了文字、公式和表格。
BATCH
桌面端可直接处理完整文档和重复转换任务,无需先把 PDF 拆成截图。
USES
当文档需要脱离固定页面布局继续使用时,Markdown 会更方便。
LIMITS
PDF 转换并非无损。用于生产或发布前,请检查生成的 Markdown。
RELATED
需要便携的结构化文本时使用 Markdown;需要其他输出时,可选择对应的 FreeOCR 工作流。
FAQ
下载 FreeOCR 桌面端,选择一个或多个 PDF 文件,将输出格式设为 Markdown,然后开始 OCR。每个源 PDF 会保存为一个 .md 文件。
可以。FreeOCR 会渲染每一页并使用 AI OCR,因此可以读取没有可选择文本的扫描版和纯图片 PDF。
FreeOCR 可将识别出的表格表示为 Markdown 表格,将公式表示为兼容 Markdown 的 LaTeX。结果取决于扫描质量,请务必检查。
可以。桌面端支持选择多个 PDF 或整个文件夹,会自动排队处理,并为每个 PDF 保存独立的 Markdown 文件。
不可以。完整 PDF 转换在 FreeOCR 桌面端运行,不在浏览器中运行。桌面端可处理多页 PDF 和多个文件。
完整 PDF 转换在 FreeOCR Desktop 中进行,不在浏览器中处理,每页消耗 1 积分。登录同一账户即可使用永久积分或订阅积分,无需强制订阅。 桌面端会在处理前显示页数并检查可用积分。
下载 FreeOCR 桌面端,选择 PDF,通过 AI OCR 导出结构化 .md 文件。
每页 PDF 消耗 1 个积分 · 支持多个 PDF 和文件夹