インテリジェントなデスクトップOCR
ネイティブデスクトップアプリで生産性を向上させましょう。高負荷な作業やプロフェッショナルなドキュメント処理向けに設計されています。
Desktopは現在開発中です。ご提案や問題がある場合は、メールでお問い合わせください admin@freeocr.ai
プロフェッショナル向け
高い精度とレイアウト保持により、PDFドキュメントを編集可能な形式に一括変換します。
手書きのメモやドキュメントを認識するために特別に調整された高度なAIモデル。
複雑な数式や方程式をLaTeXや編集可能なテキストにシームレスに抽出します。
入れ子になった表や枠線のない表でも構造を維持するインテリジェントな表認識。
PDF OCR
PDFを3つの出力形式へ一括処理
BENCHMARK
大容量ドキュメントと書籍専用の設計
アップロード制限やブラウザのクラッシュに縛られず、FreeOCR Desktopは数百ページの古文書・大部活字文書を安定してバッチ処理します。
高負荷ベンチマーク
318MBのスキャン大部書をメモリ枯渇ゼロで処理完了
FreeOCR Desktopのネイティブパイプラインで実行。1884年の歴史的ジャーナルを途中で分割することなく、14.4MBの構造化Markdownへ一括変換しました。
IMAGE BATCH
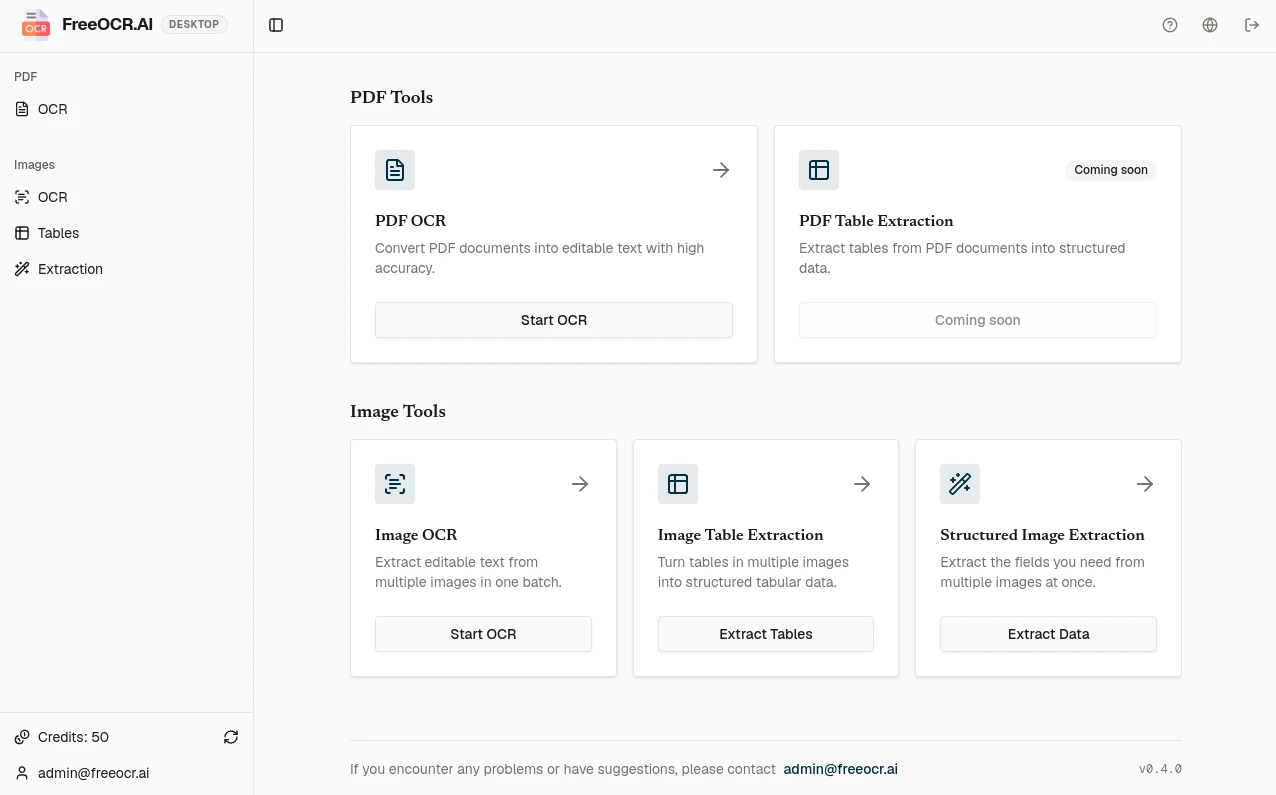
画像を一括処理し、結果を元画像の横に保存
一度の選択で
複数の画像、またはフォルダー全体
テキスト、表、または構造化項目を一括で抽出します。
画像から文字へ
編集可能なテキスト、Markdown、Wordファイルを一括で書き出します。
画像OCRをオンラインで使う画像からExcelへ
画像内の表をCSVまたはExcelファイルに一括変換します。
画像内の表をオンラインで抽出項目抽出
請求書番号、日付、合計額などの項目を選び、構造化データを一括で書き出します。
画像の項目をオンラインで抽出JPG、JPEG、PNG、WebP、BMP、HEIC、HEIFに対応しています。 画像は処理のためにアップロードされる前にローカルで圧縮され、クラウド履歴には追加されません。 結果は元画像を上書きせず、TXT、Markdown、Word、CSV、Excelファイルとして元画像の横に保存されます。
プライバシーを最優先に
通信の暗号化
OCR にはインターネット接続が必要です。画像または PDF から描画したページ画像を HTTPS でクラウドに送信し、認識を行います。
結果は端末に保存
認識結果はお使いのコンピューターに保存され、クラウドの履歴には追加されません。
RELEASE NOTES
最近の更新
v0.5
中断しても再開できるPDF一括処理
- PDFは1ページずつ処理されるため、途中で中断しても認識済みのページは保持されます。
- 停止した位置から再開するか、完了したページだけを書き出せます。
- 認識はページ単位で課金され、失敗したページは返金されます。クレジットが不足するとチャージページが開きます。
v0.4
画像の一括処理
- 複数の画像をテキスト、Markdown、またはWordに変換します。
- 画像内の表をCSVまたはExcelファイルに抽出します。
- 請求書番号、日付、合計額などの項目を選び、構造化データをCSVまたはExcelに書き出します。
v0.3
PDFの一括処理
- 複数のPDFまたはフォルダー全体を1つのキューで処理できます。
- 各PDFをテキスト、Markdown、またはWordに書き出せます。
- 各ファイルの進捗を確認し、失敗したPDFを再試行して、結果を元ファイルの横に保存できます。
レベルアップの準備はできましたか?
永久クレジットとサブスクリプションのクレジットは、通常のツールページ、ワークスペース、FreeOCR Desktop で使えます。どちらも一括処理に利用でき、サブスクリプションは必須ではありません。